韓国の政治YouTubeのチャットを広聴AIで分析する(韓国日報)
韓国日報(한국일보)の企画「유튜브 부족주의(YouTube部族主義)」の取材で、韓国日報が収集した韓国の政治YouTube 6チャンネルのライブチャットを、西尾泰和(デジタル民主主義2030)が広聴AIで分析しました。結果は2026年10月22日の記事2本で紹介されました。このページでは、その分析結果を公開します。
YouTubeのチャットも「陣営」を外してまとめれば違って見える? 「市民の声」を探す日本のエンジニア 유튜브 채팅도 '진영' 떼고 묶으면 달리 보인다? '시민 목소리' 찾는 日엔지니어 | 韓国日報 2026年10月22日
2026年10月8日に行った西尾泰和への取材記事です。広聴AIで韓国の政治YouTubeのチャットを可視化し、立場が正反対の意見でも同じ話題なら一つのまとまりになることや、陣営の対立に隠れた市民の関心を見つける考え方を紹介しています。Code for Japan の取り組みもあわせて取り上げています。
記事を読む(韓国語・新しいタブ) →韓国の政治YouTubeは公共的議論の場として落第? 日本のエンジニアの診断は 한국 정치 유튜브, 공론장으로 낙제점?… 일본 엔지니어의 진단은 | 韓国日報 2026年10月22日
政治YouTube 6チャンネルのチャットを、西尾泰和と広聴AIで分析した結果を伝える記事です。特定の政治家への支持と非難、相手陣営の排除を求める声が多く、政策につながる議論は少なかった一方で、どちらか一方の陣営だけが占める話題はありませんでした。あわせて、一つのプラットフォームの声を世論全体と見なさず、複数の経路から意見を集める必要性を取り上げています。
記事を読む(韓国語・新しいタブ) →分析したデータ
進歩寄りの3チャンネル(キム・オジュンのニュース工場、メブルショー、イ・ドンヒョンTV)と、保守寄りの3チャンネル(コ・ソングクTV、ペ・スンヒ弁護士、神の一手)の、2026年1〜8月のライブチャットから、チャンネルごとに500件ずつ、計3,000件を選びました。進歩寄り・保守寄りはチャンネルの一般的な分類で、投稿者本人の立場を表すものではありません。
意見の地図
広聴AIで作った地図です。点は抽出した意見1件で、近い点ほど内容が似ています。各地図の上部で日本語・English・한국어を切り替えられます。
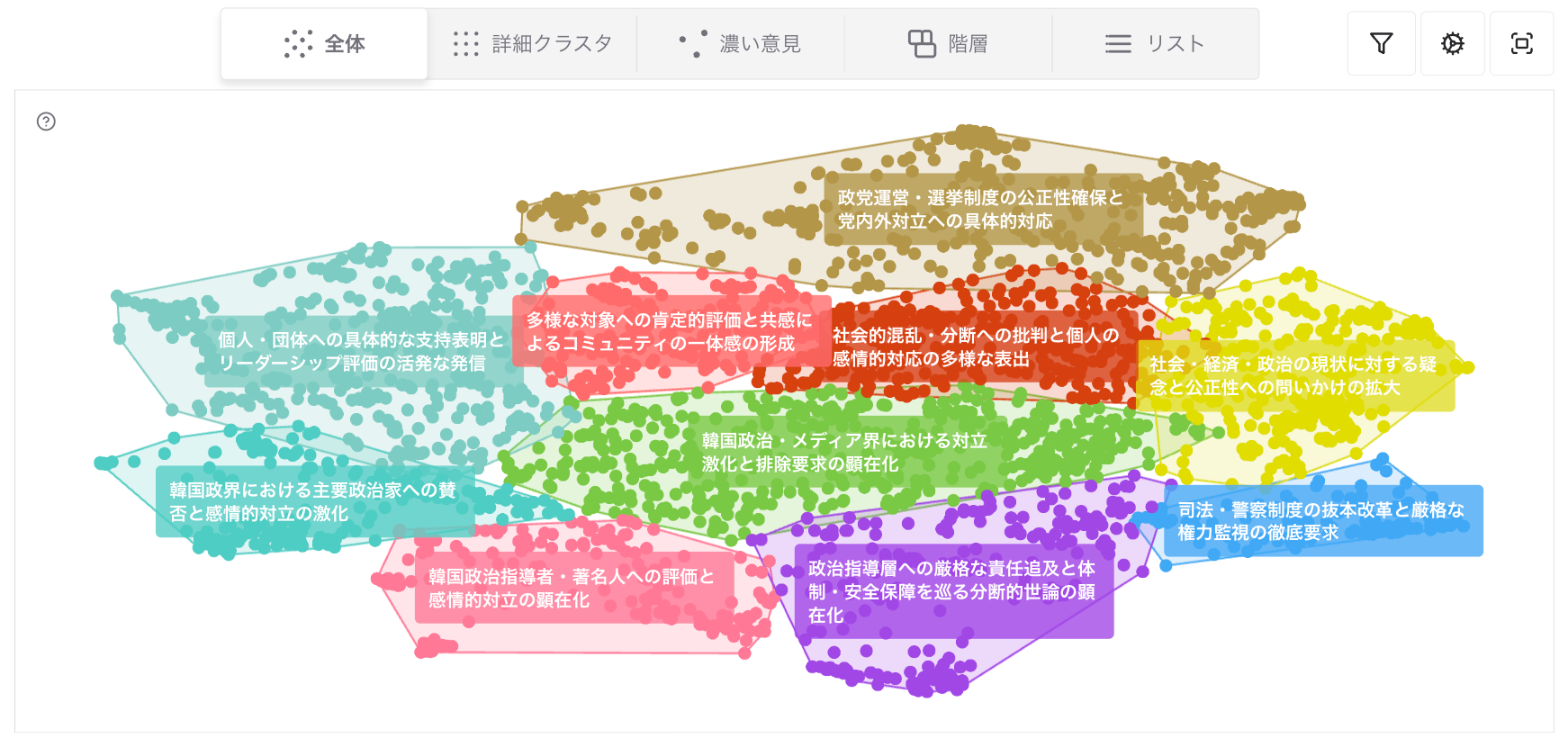
チャンネル別の地図(チャンネルごとに作り直しているので、ほかの地図とは位置・群が対応しません):
分かったこと
大きな話題は両方の陣営に共通していた
3,000件のうち2,663件から意見を抽出し、同じ文をまとめて2,914件の意見にしました。これを10の群に分けると、最も大きい群は「対立激化と排除要求」(496件)、次が「個人・団体への支持表明とリーダーシップ評価」(434件)でした。10の群のどれでも、進歩寄りチャンネルから来た意見の割合は42〜67%の間にあり(全体では51%)、どちらか一方の陣営のチャンネルだけでできた群はありませんでした。一方に大きく偏ったのは、もっと細かい群の、特定の人物についての話でした。
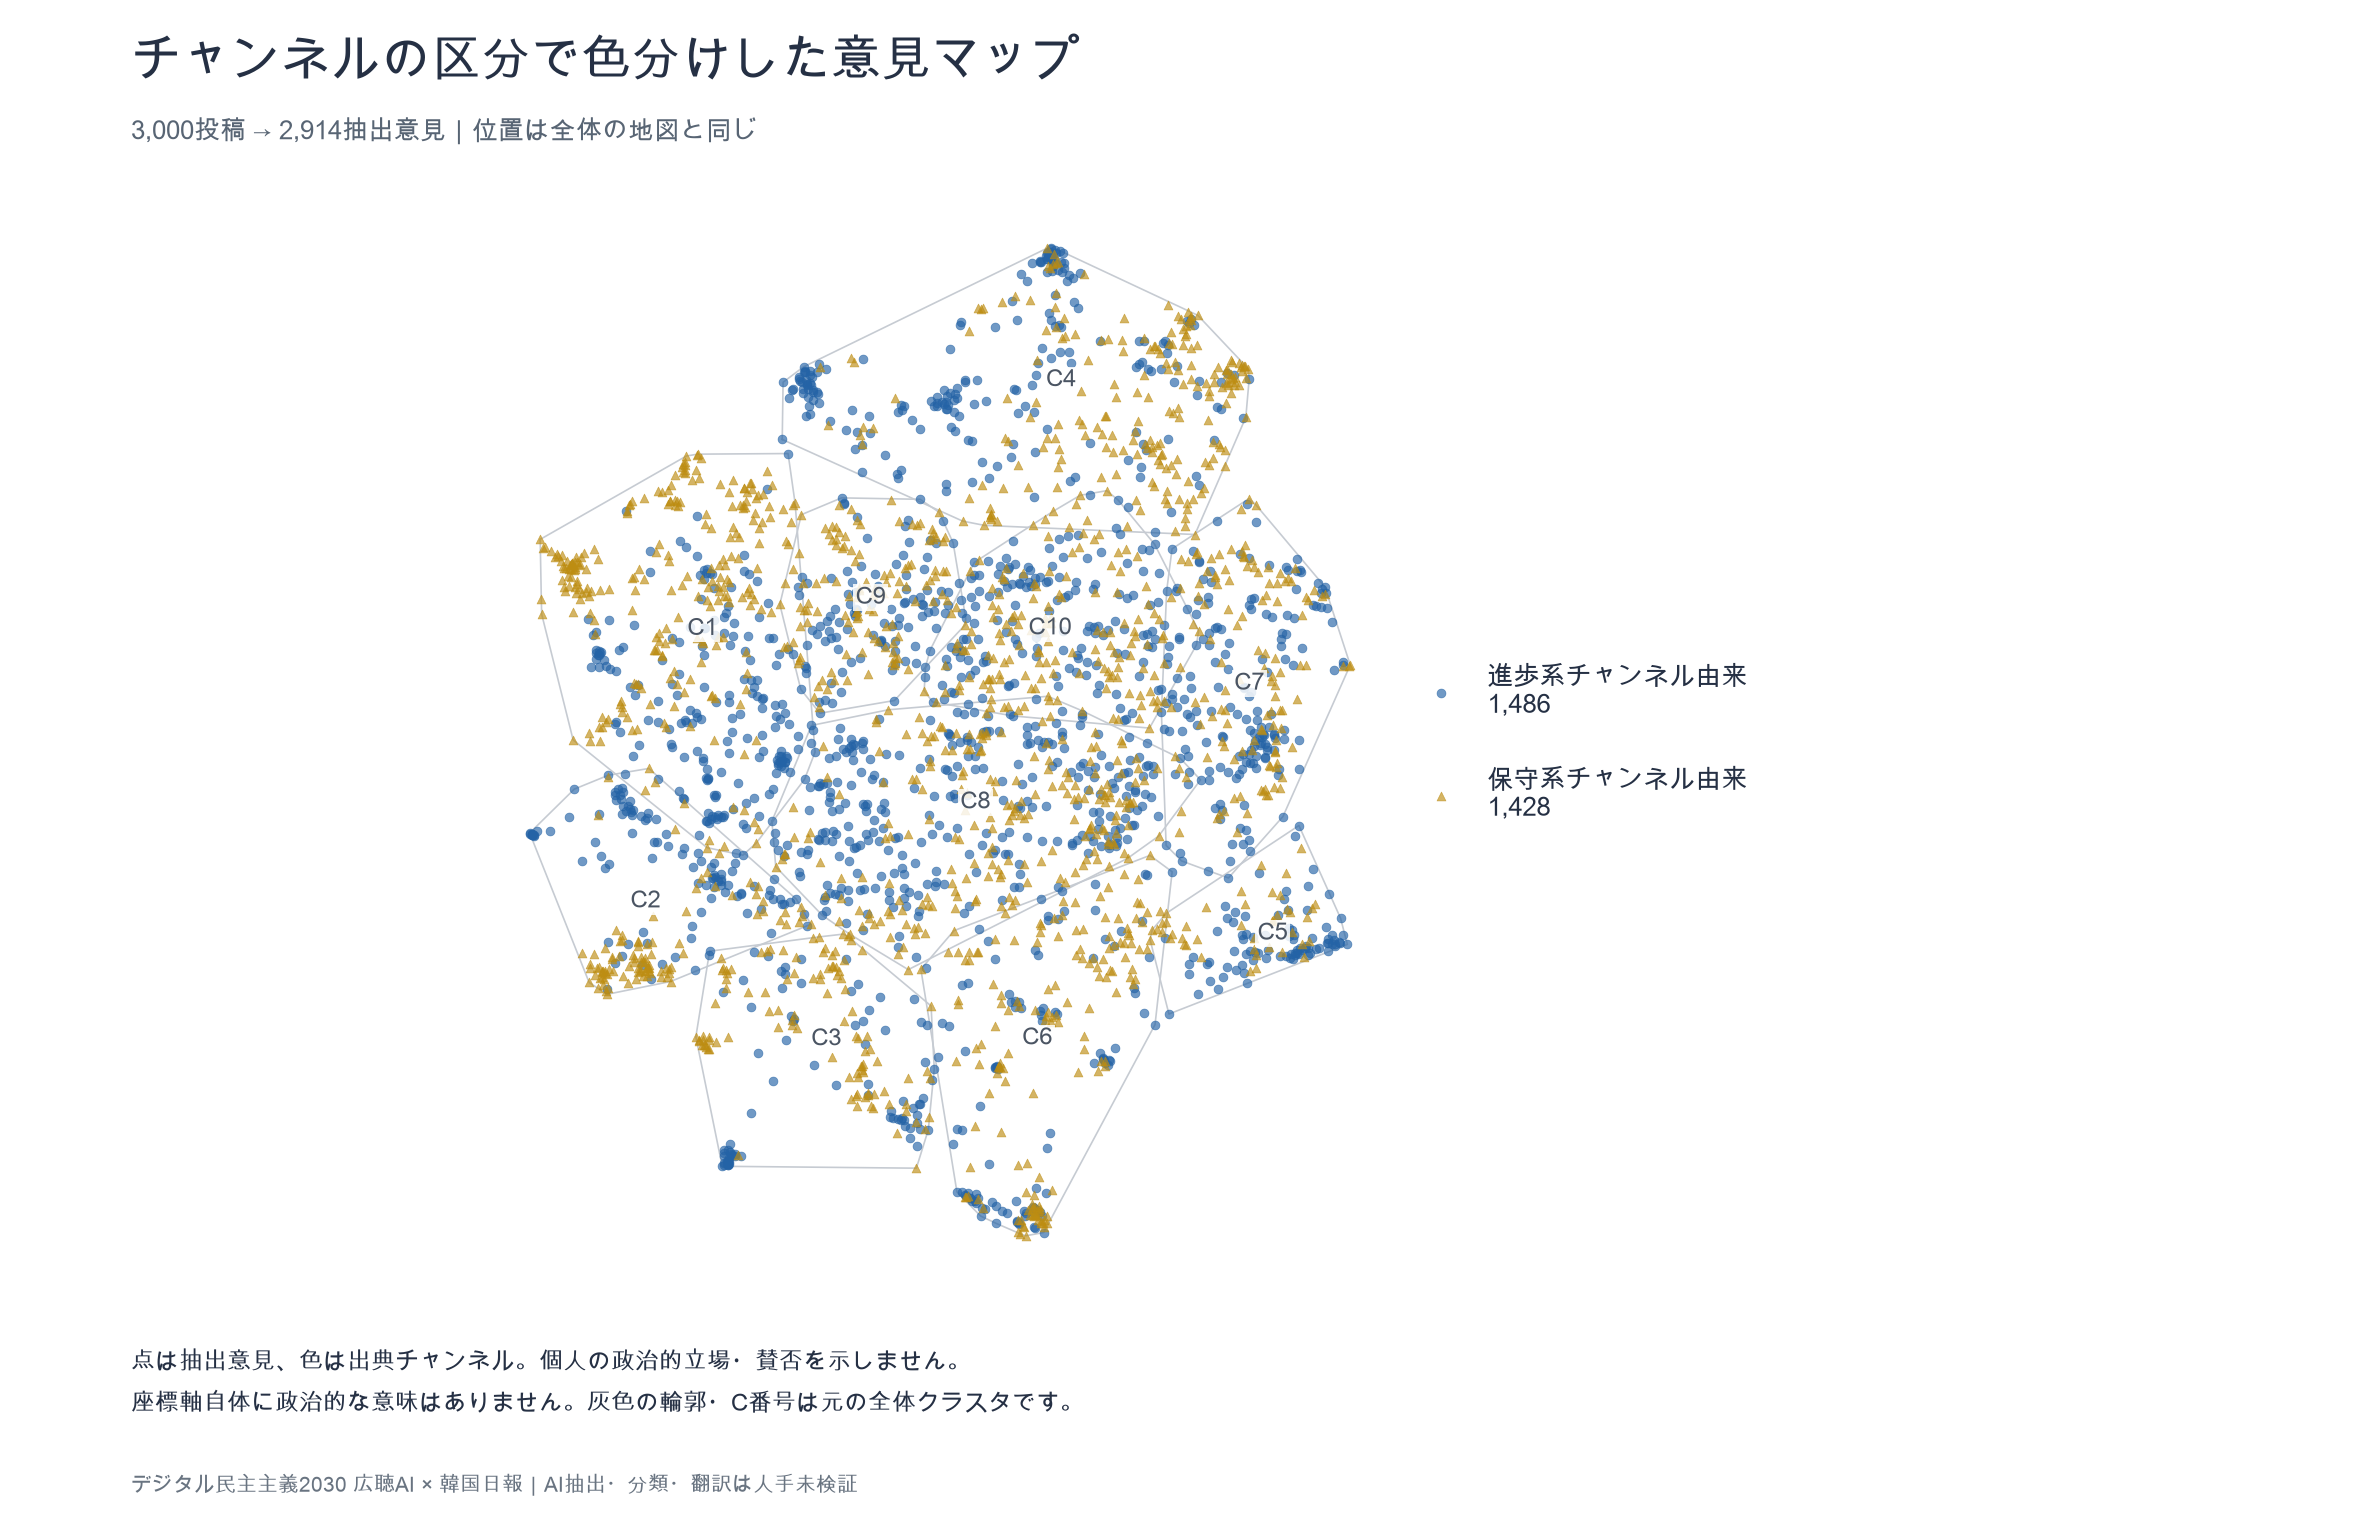
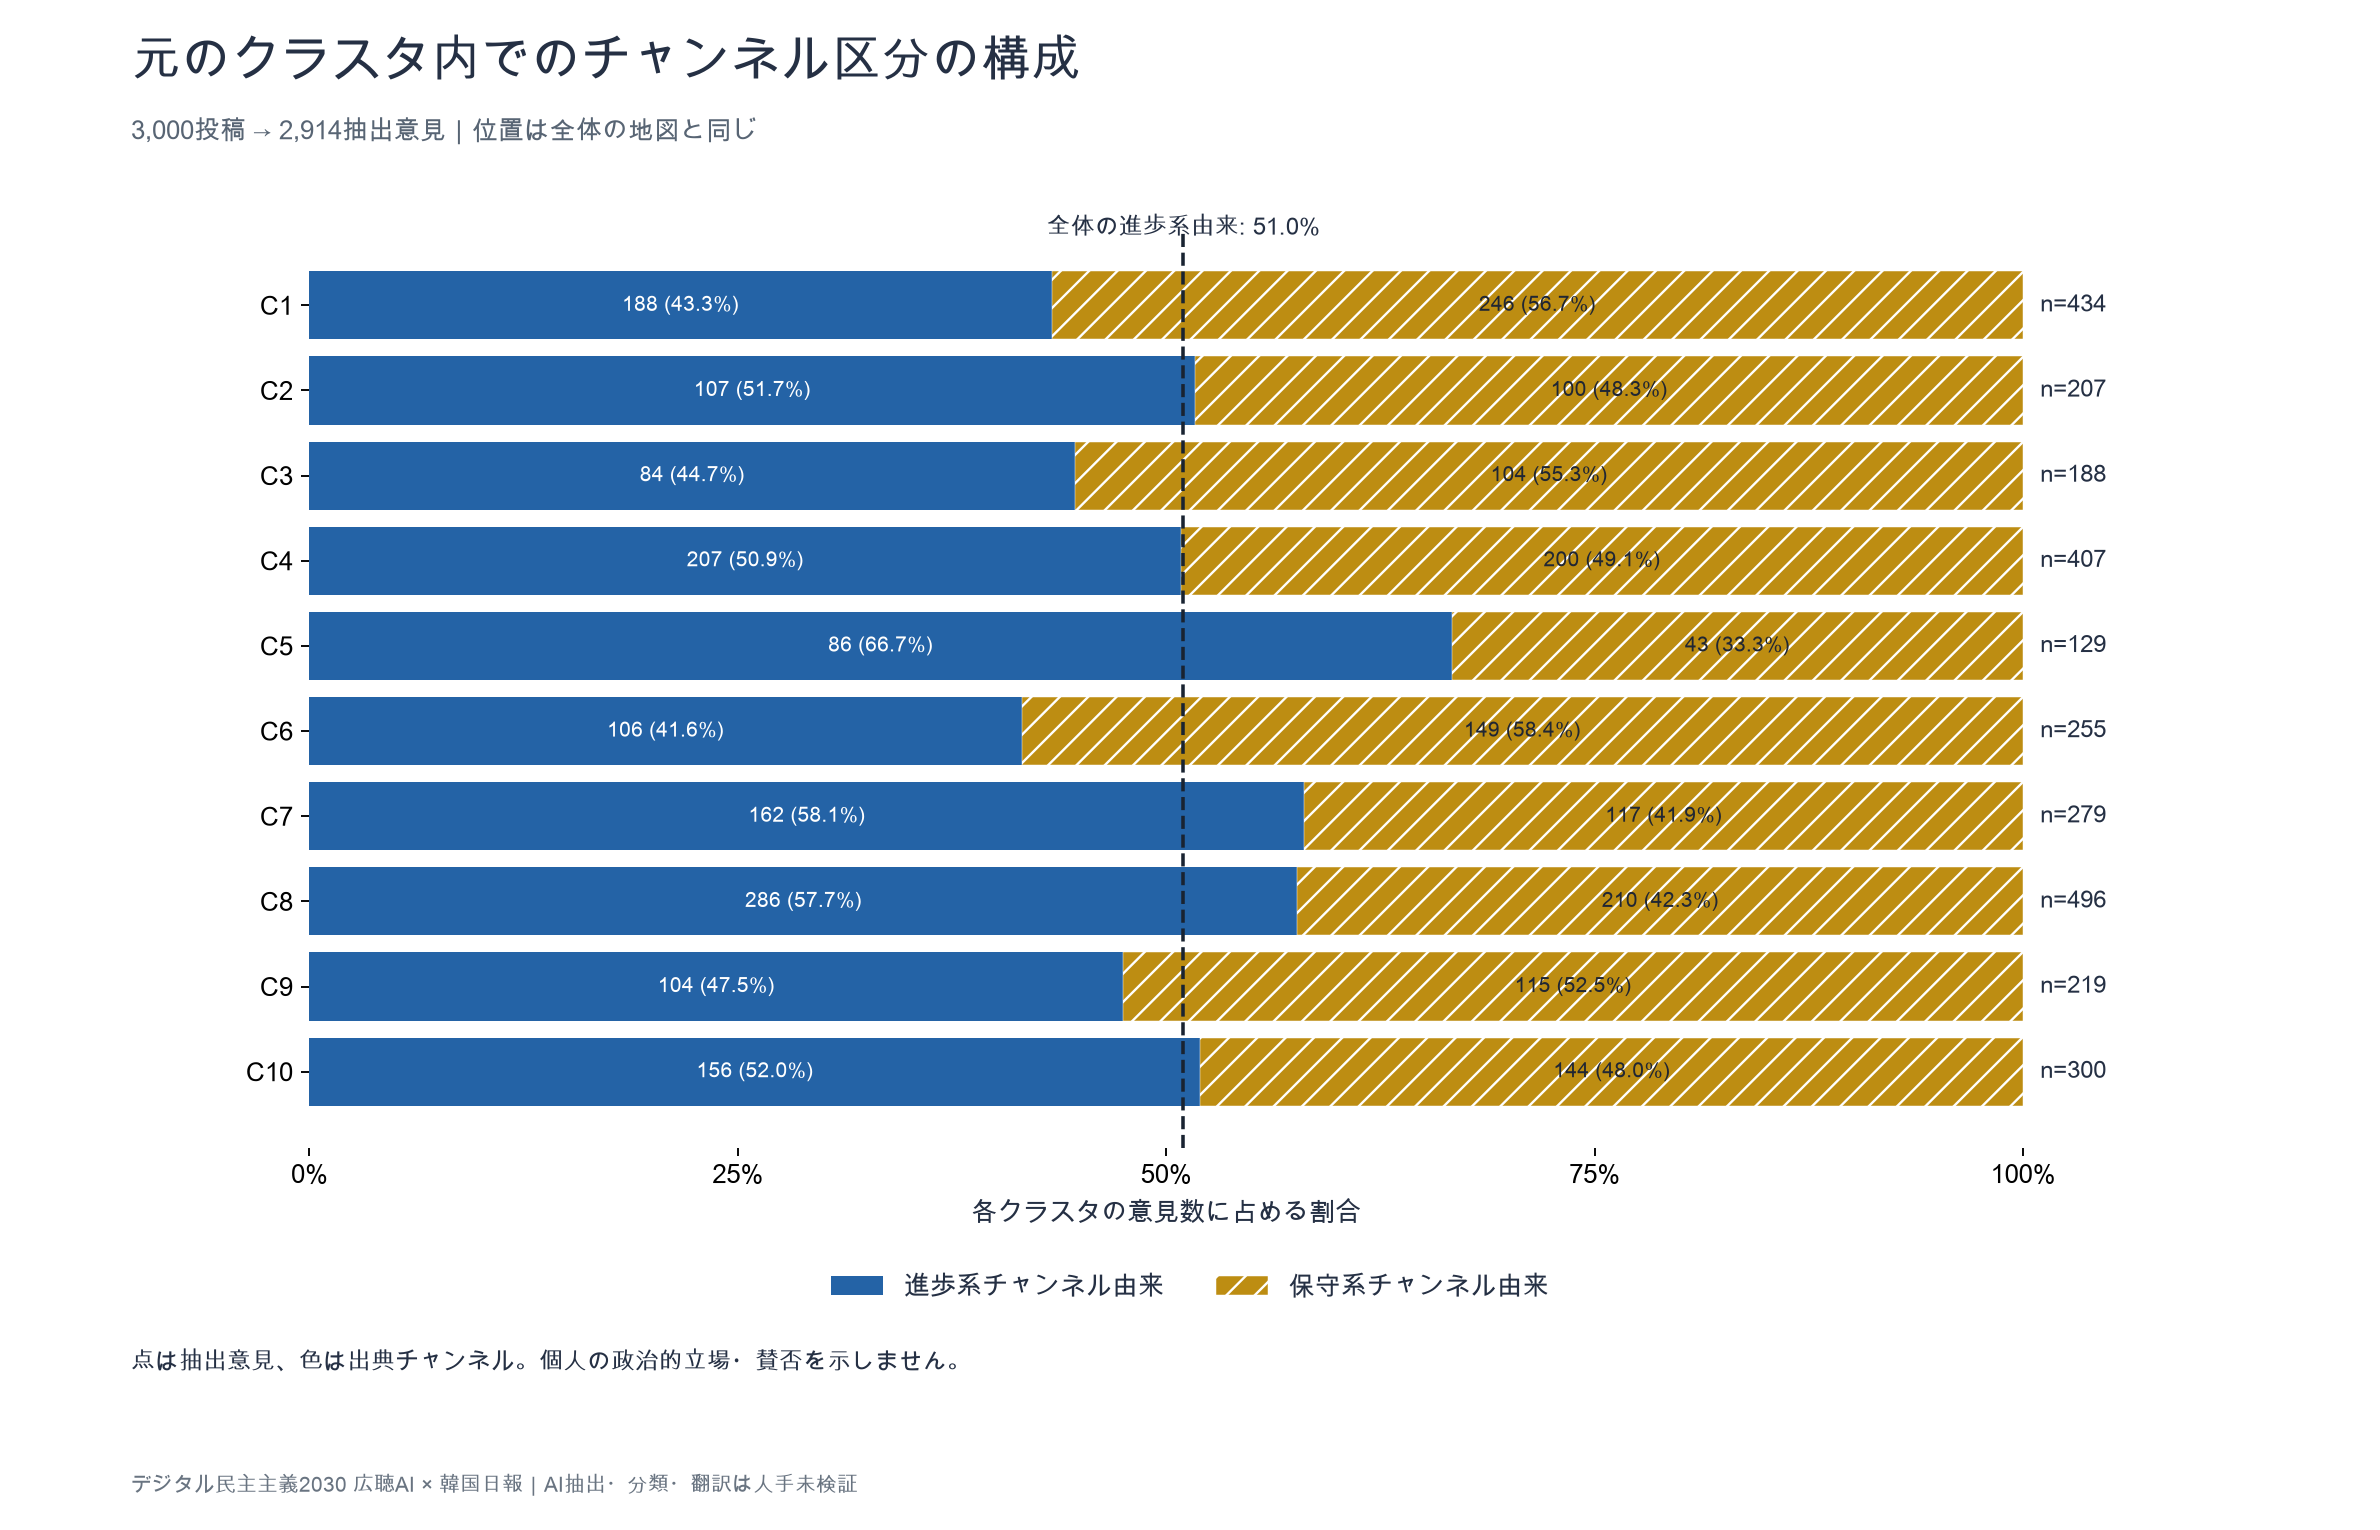
한국어: 지도 / 구성 English: map / composition
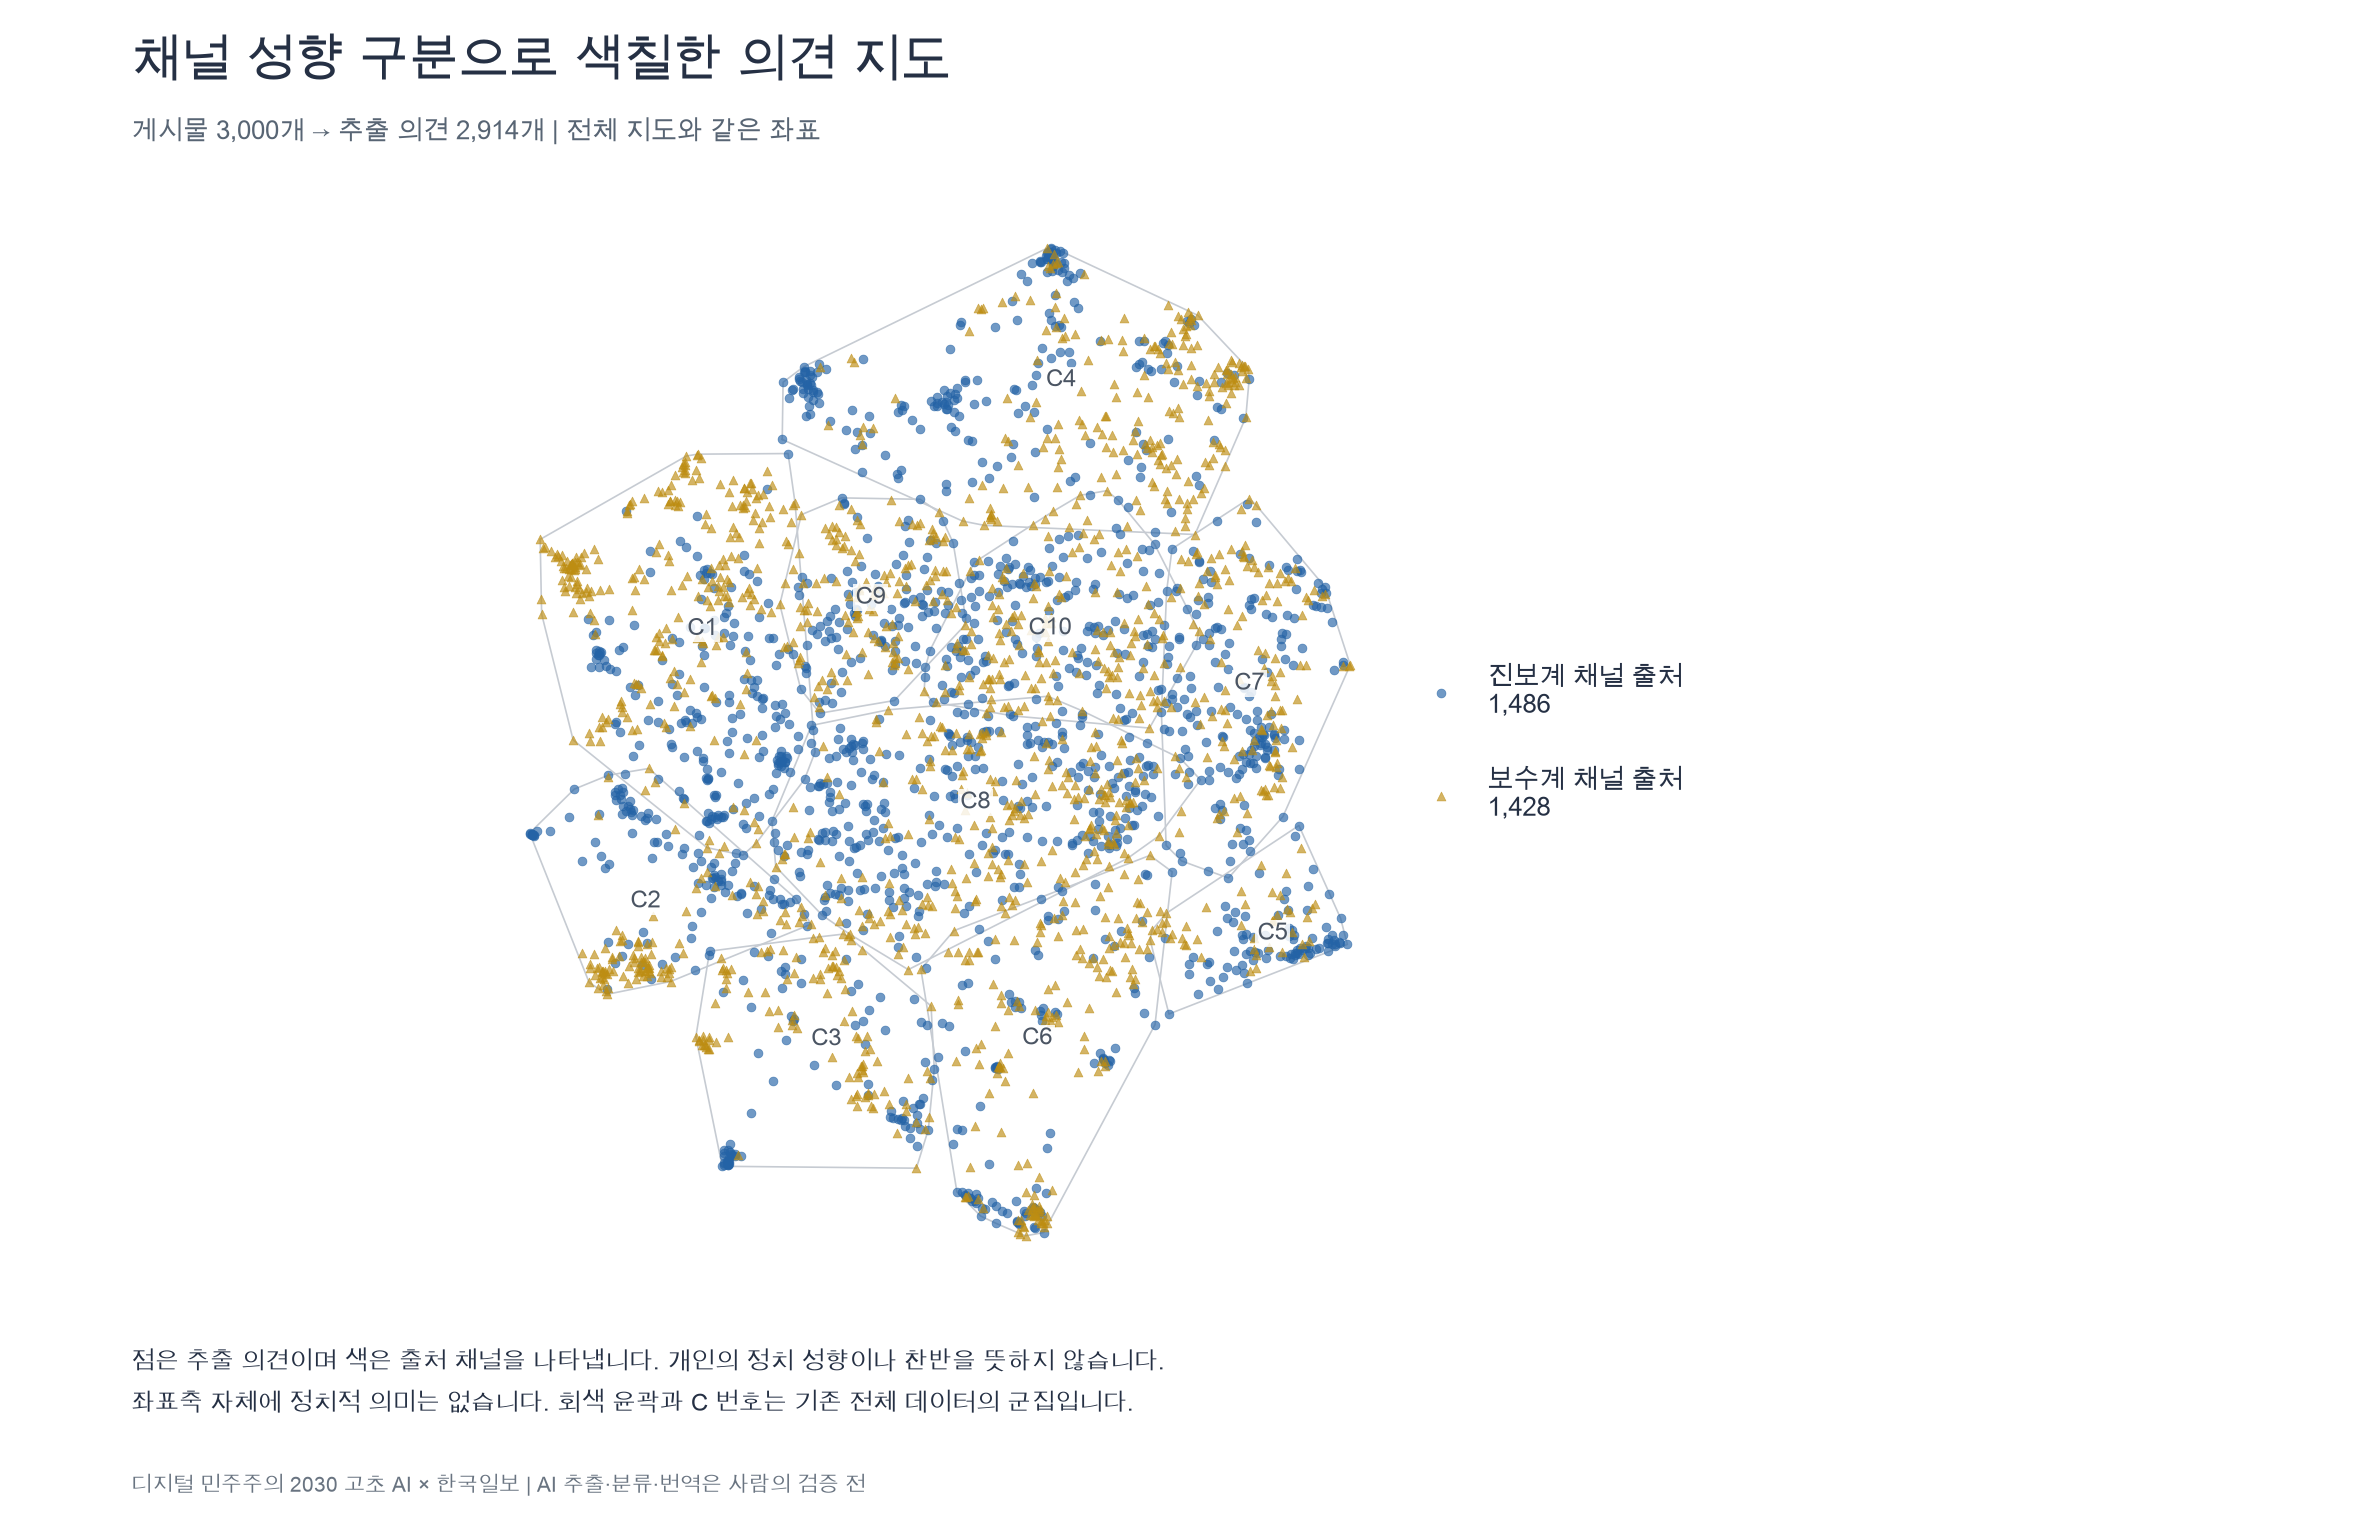
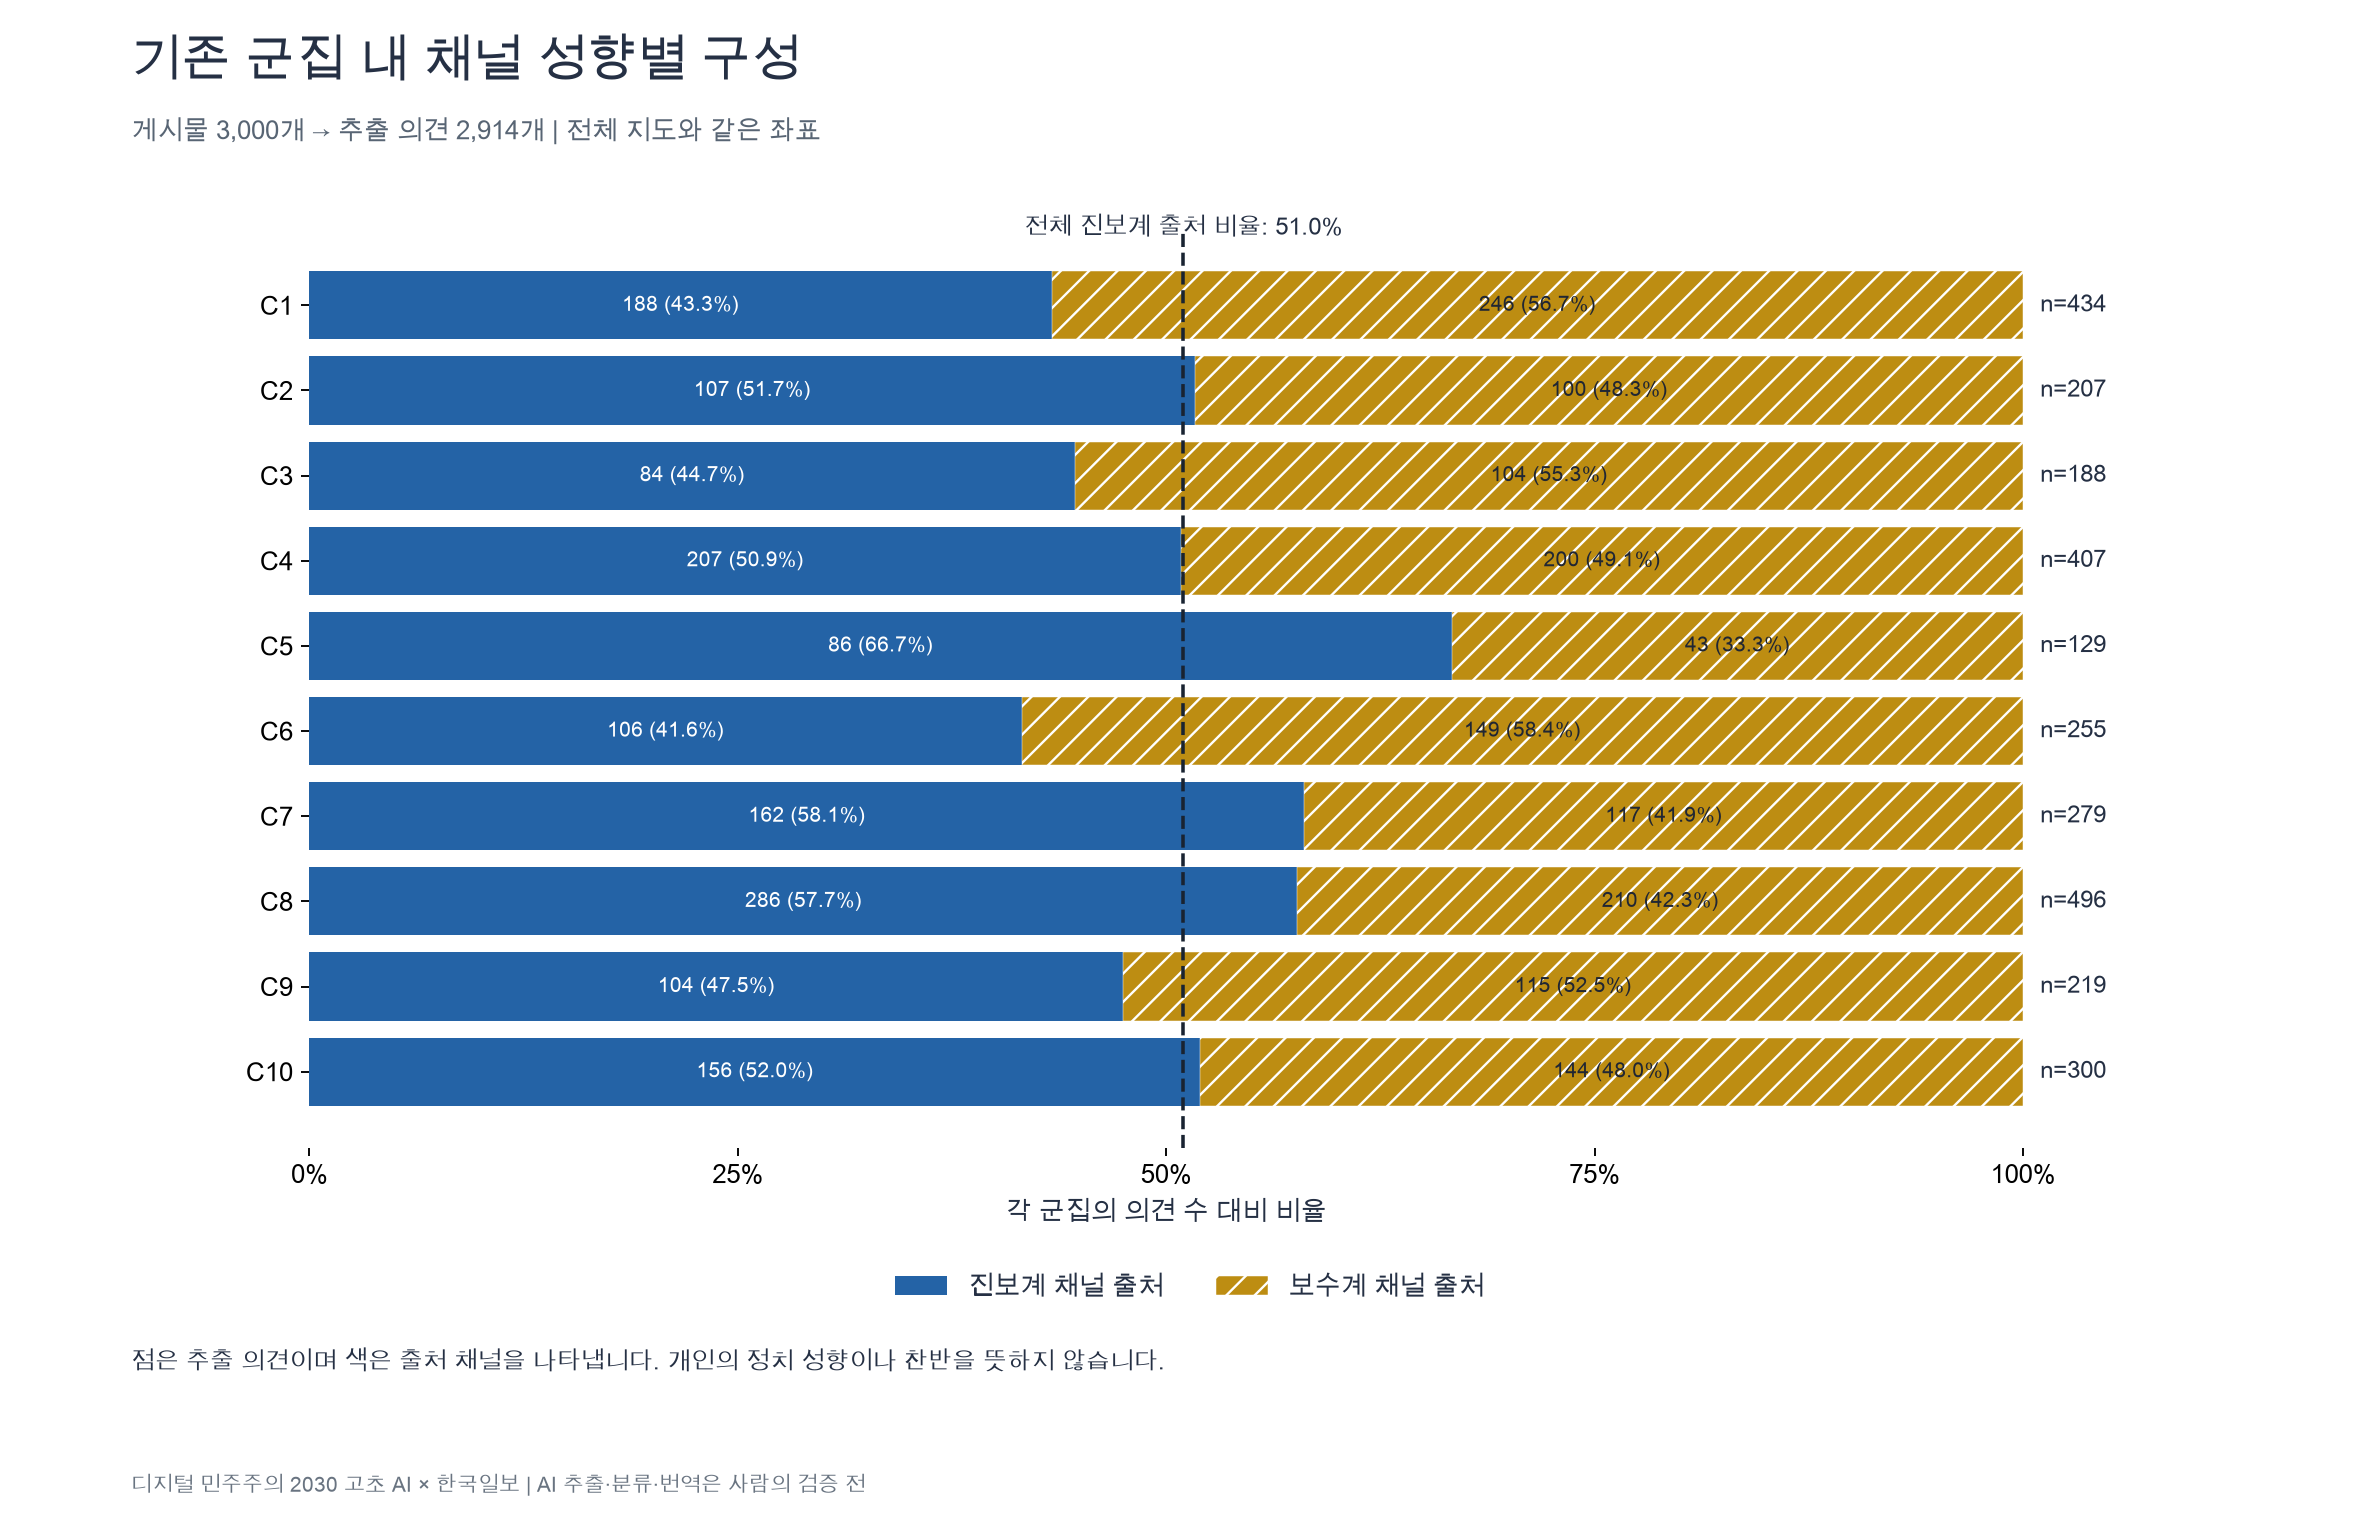
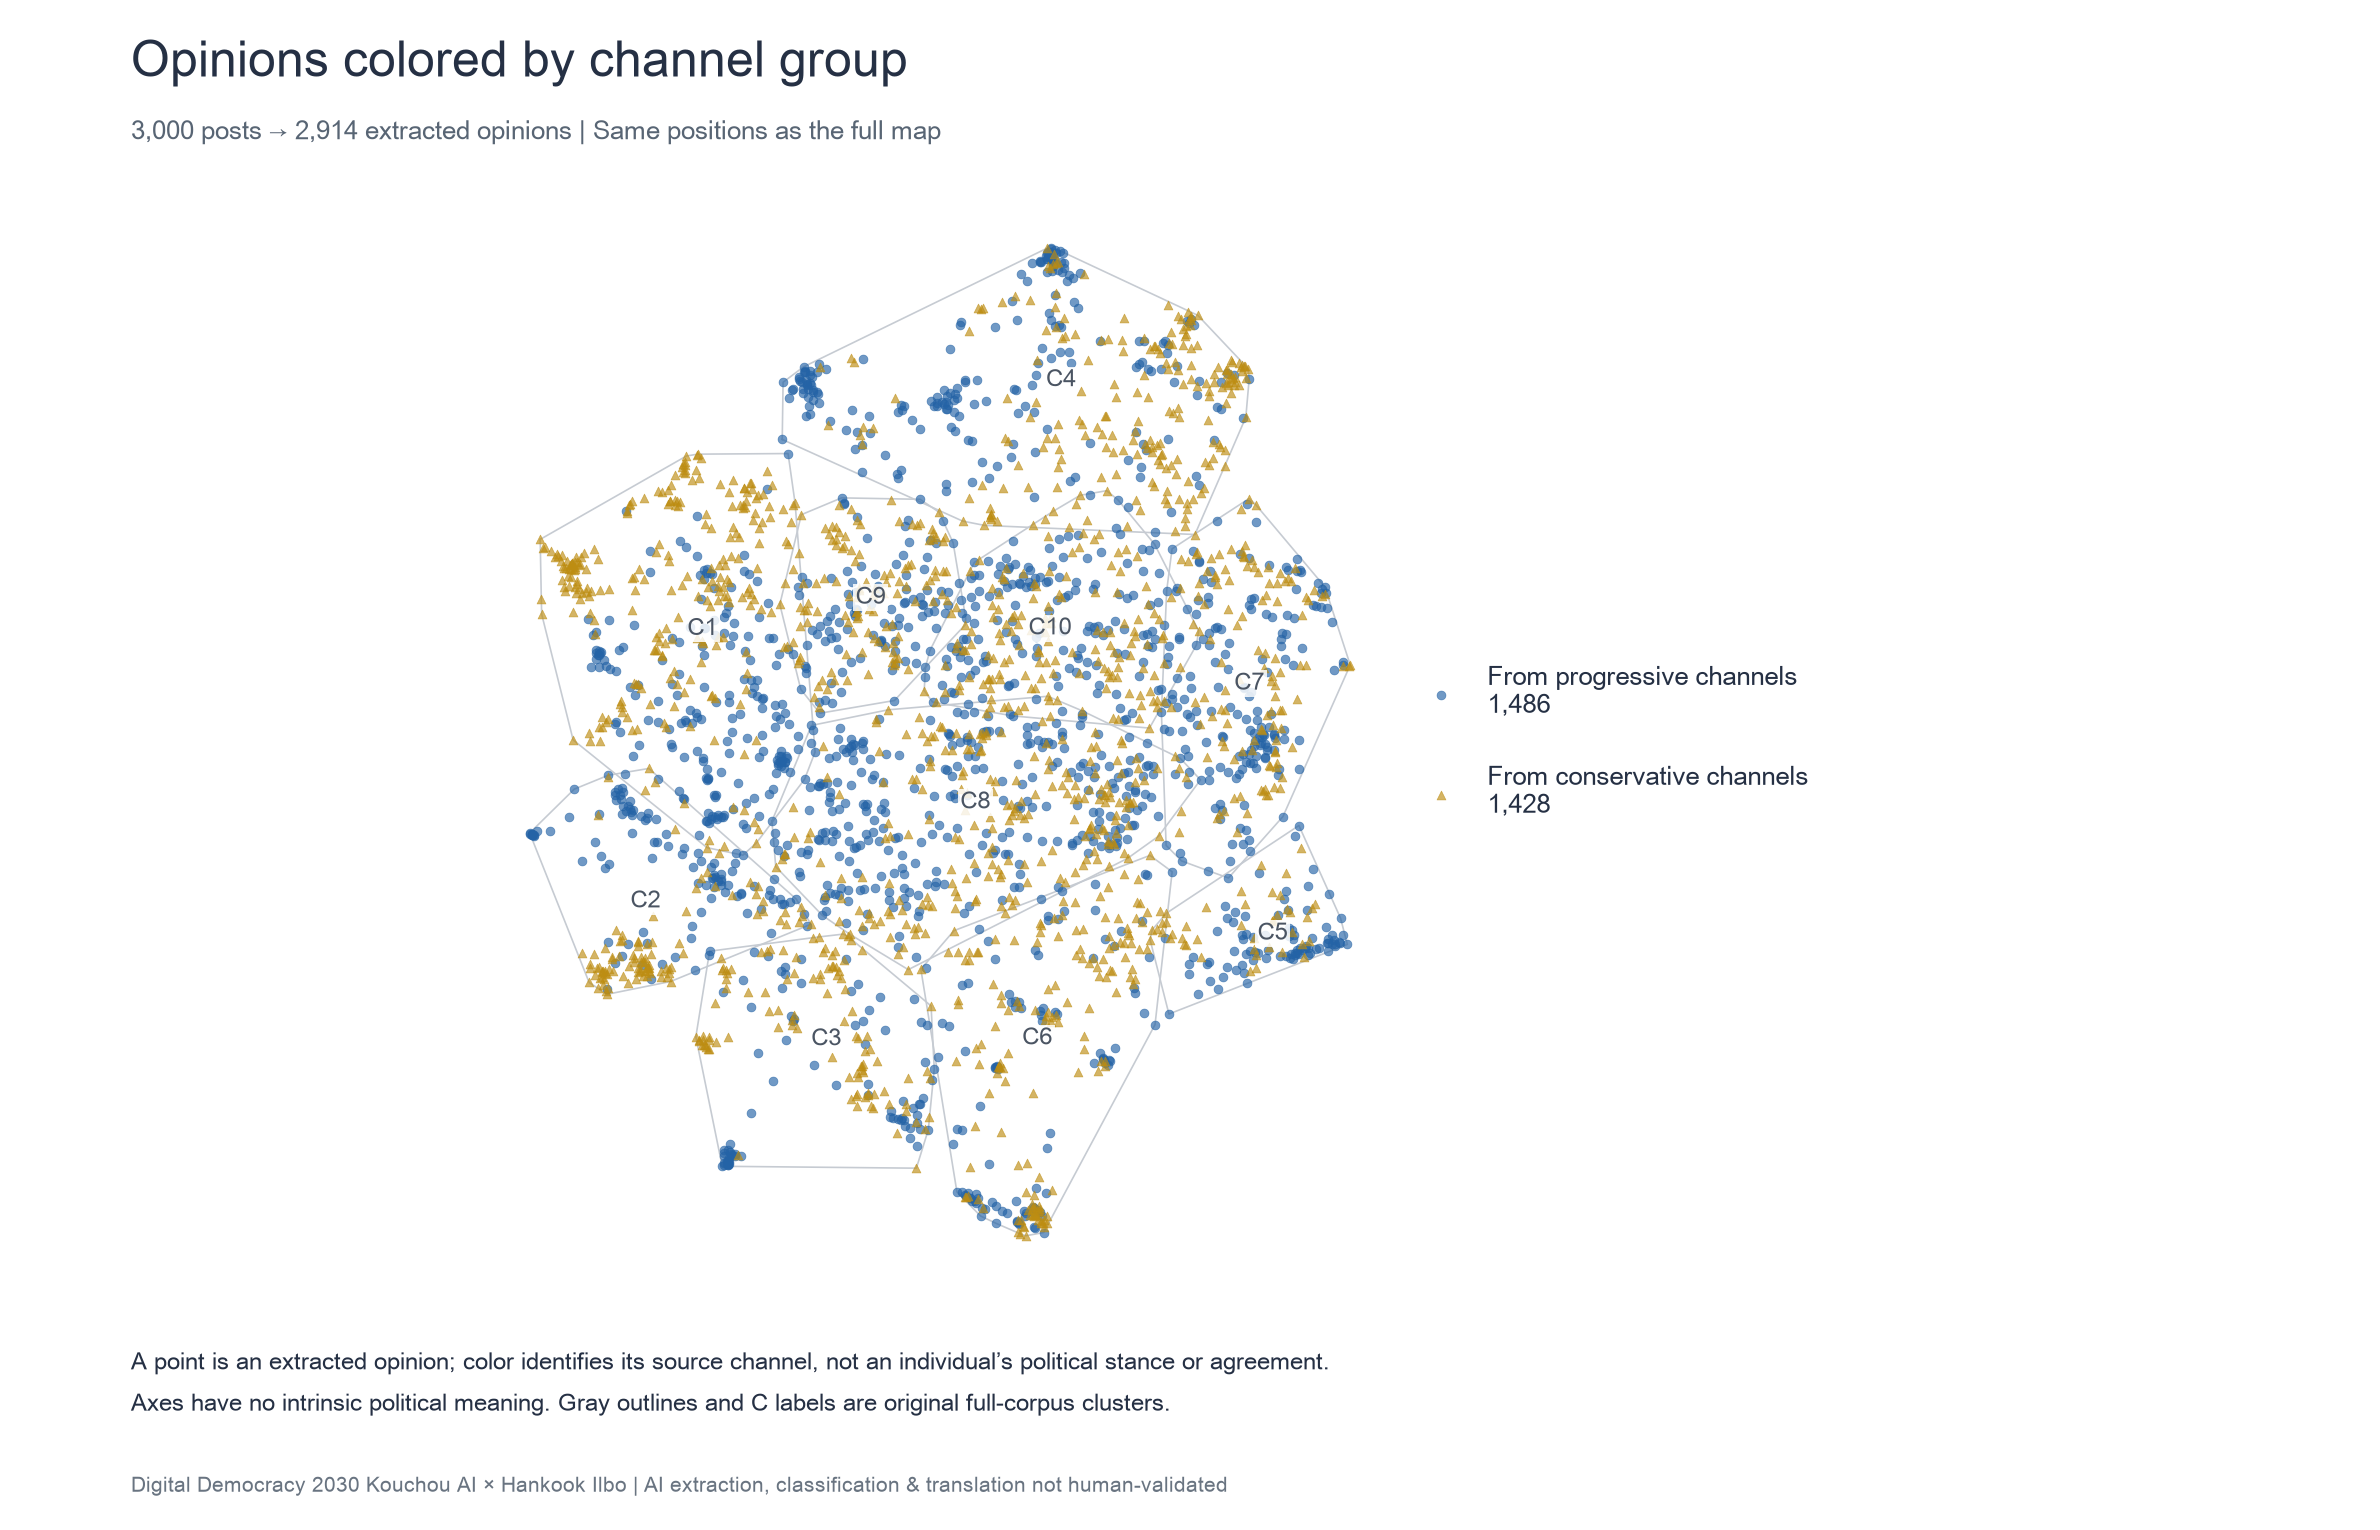
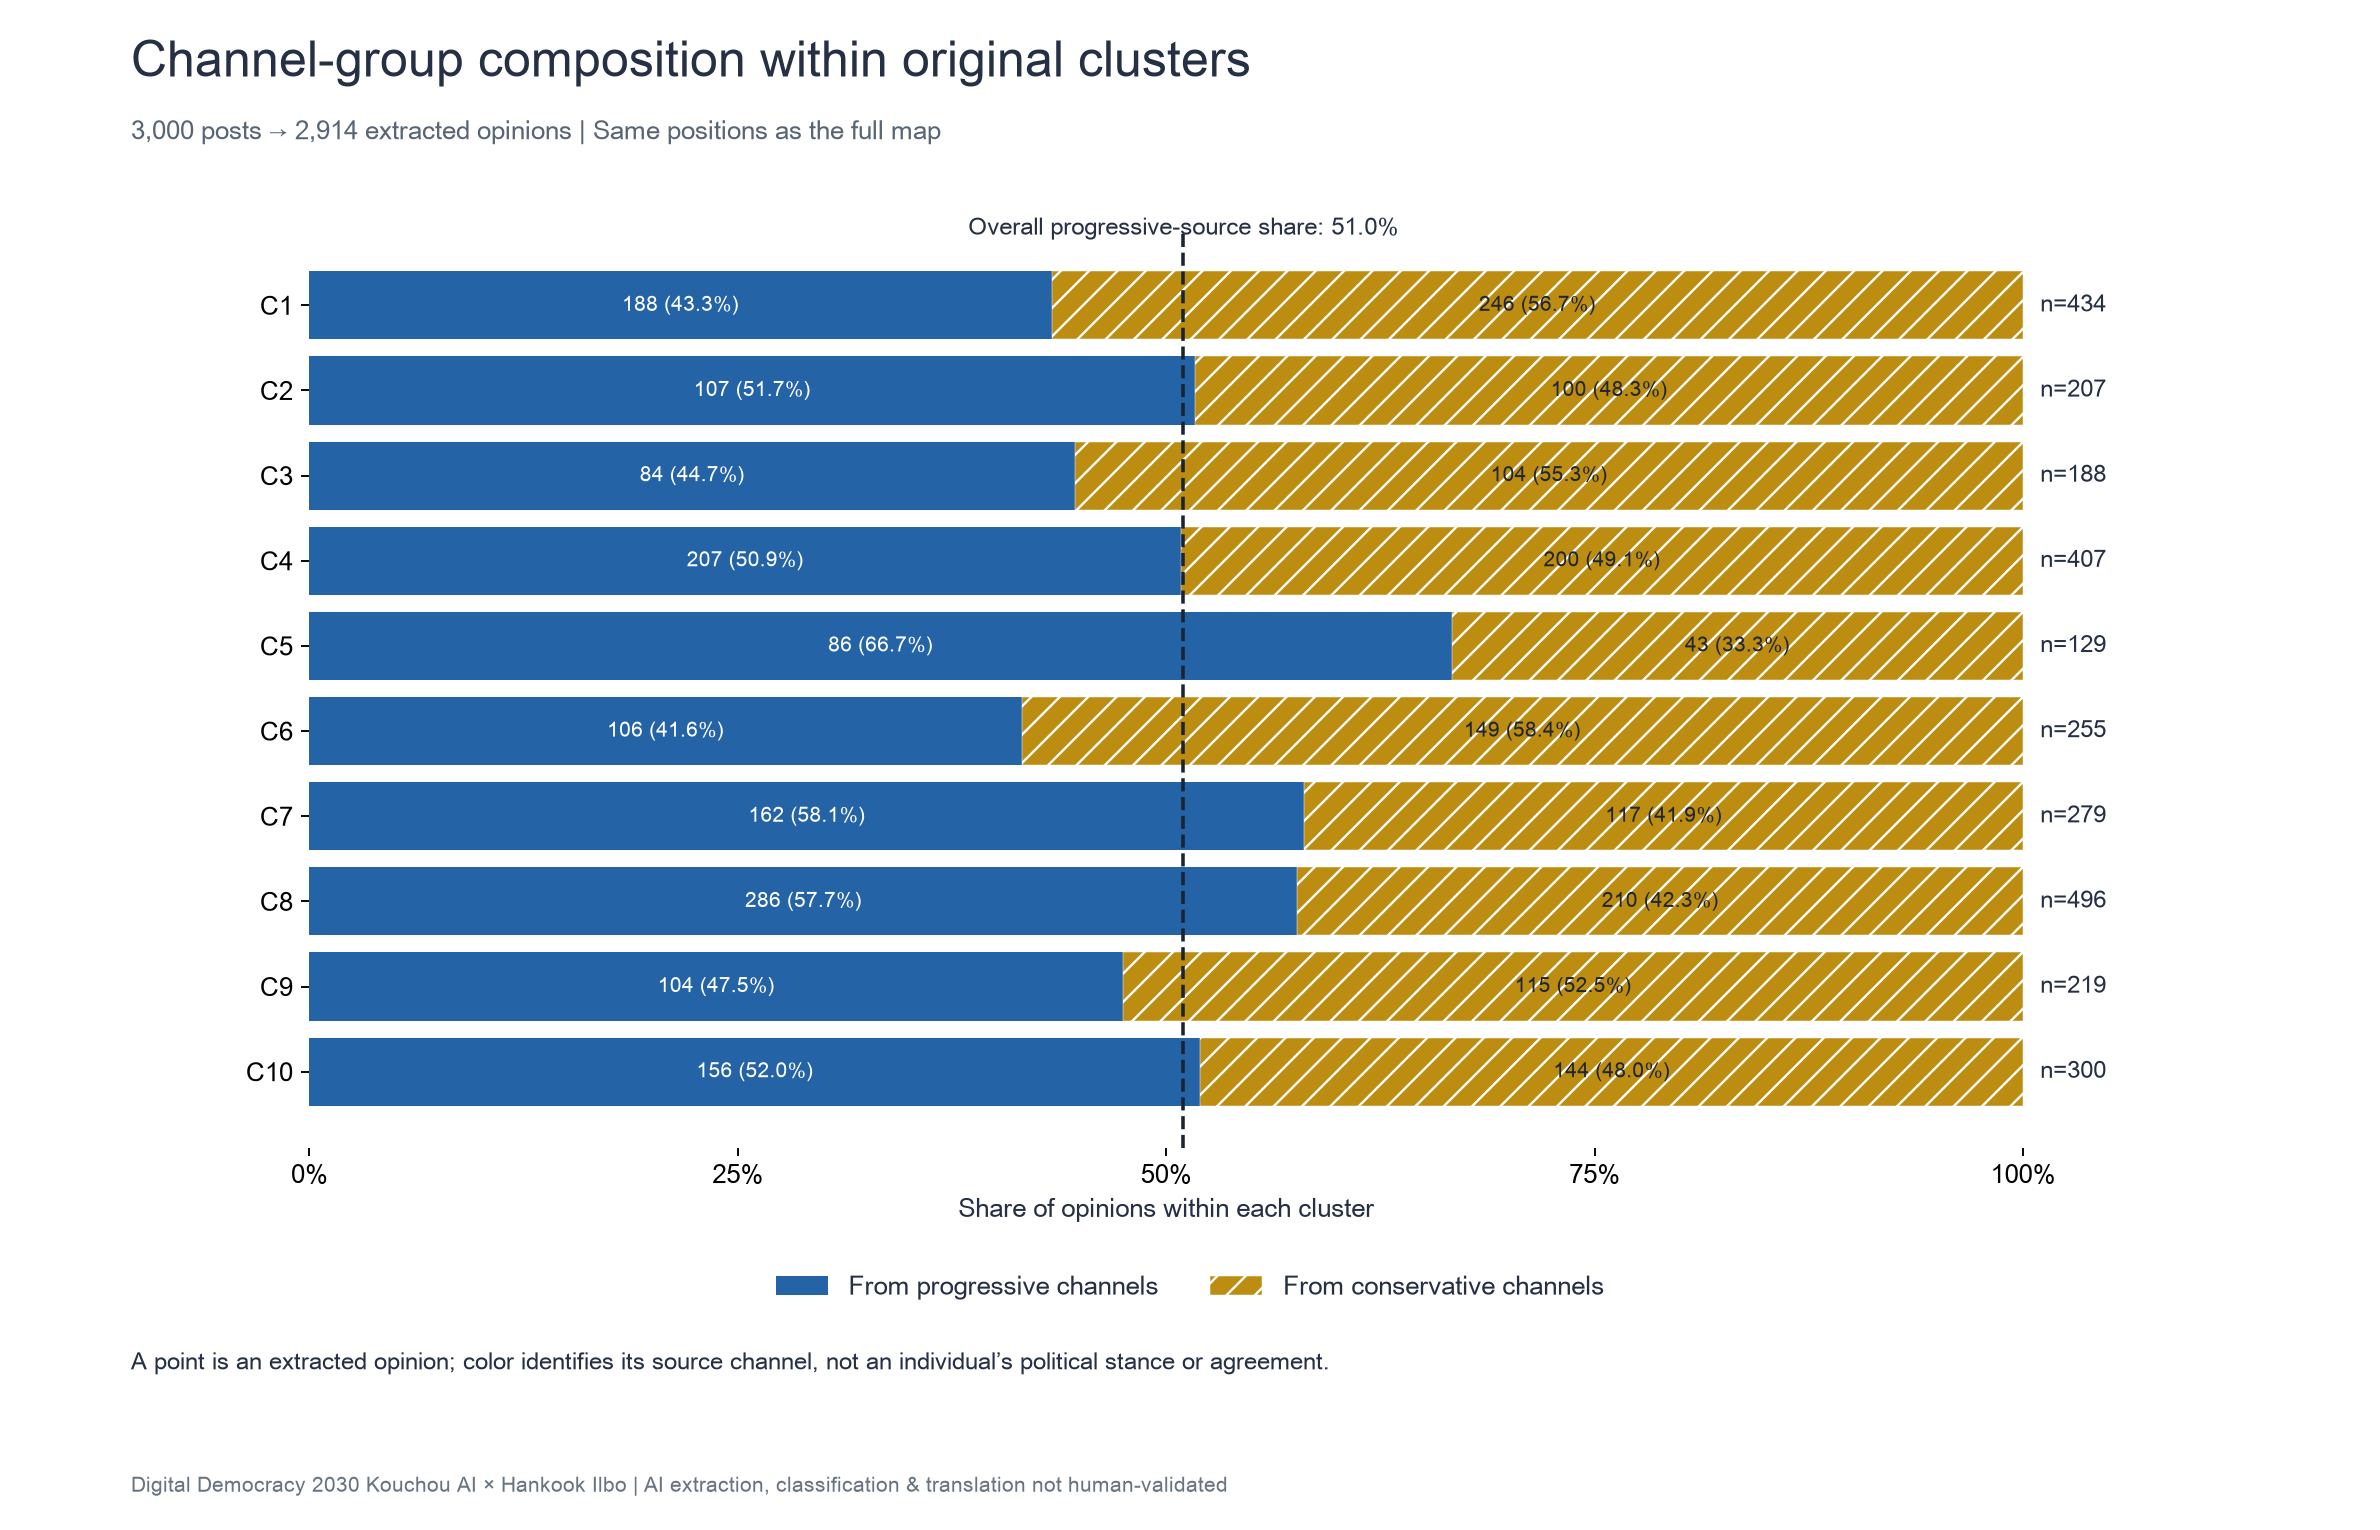
同じ話題なら、立場が逆でも同じ群に入る
広聴AIは「誰が言ったか」ではなく「何について言ったか」で意見をまとめます。そのため、同じ話題について正反対の意見が同じ群に入ります。群が同じでも、立場まで同じとは限りません。賛否の割合は出していません。
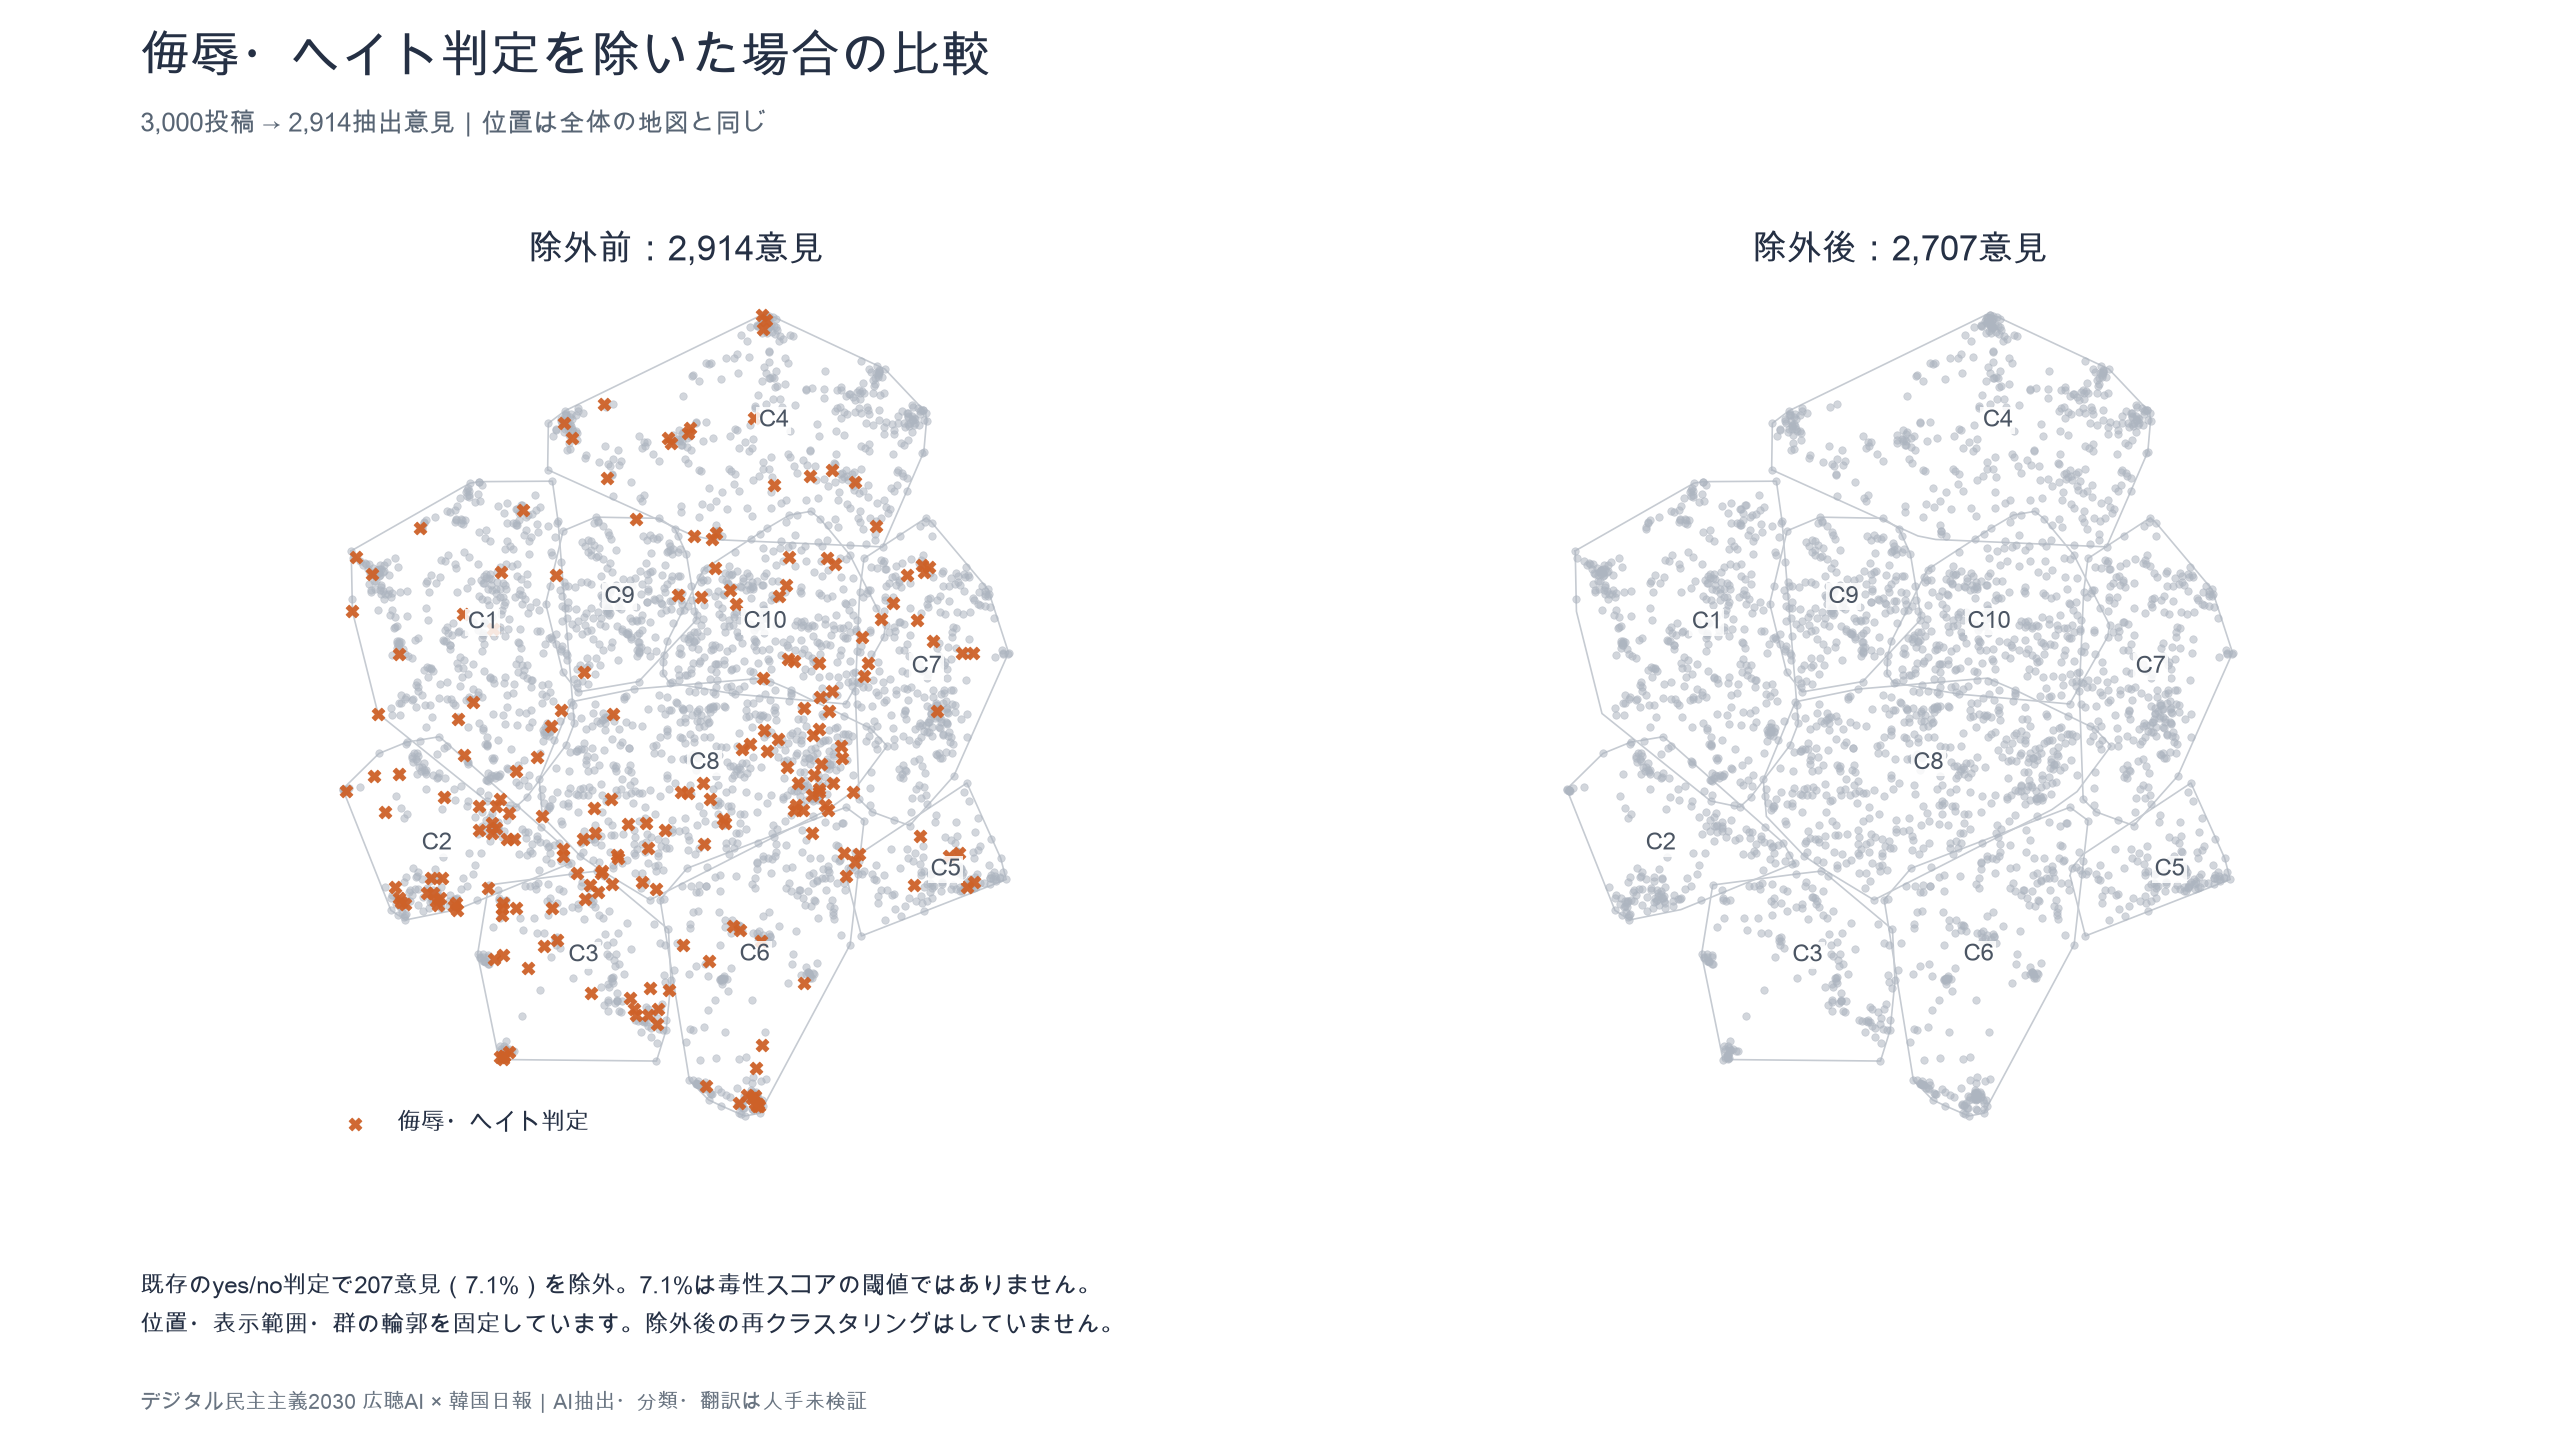
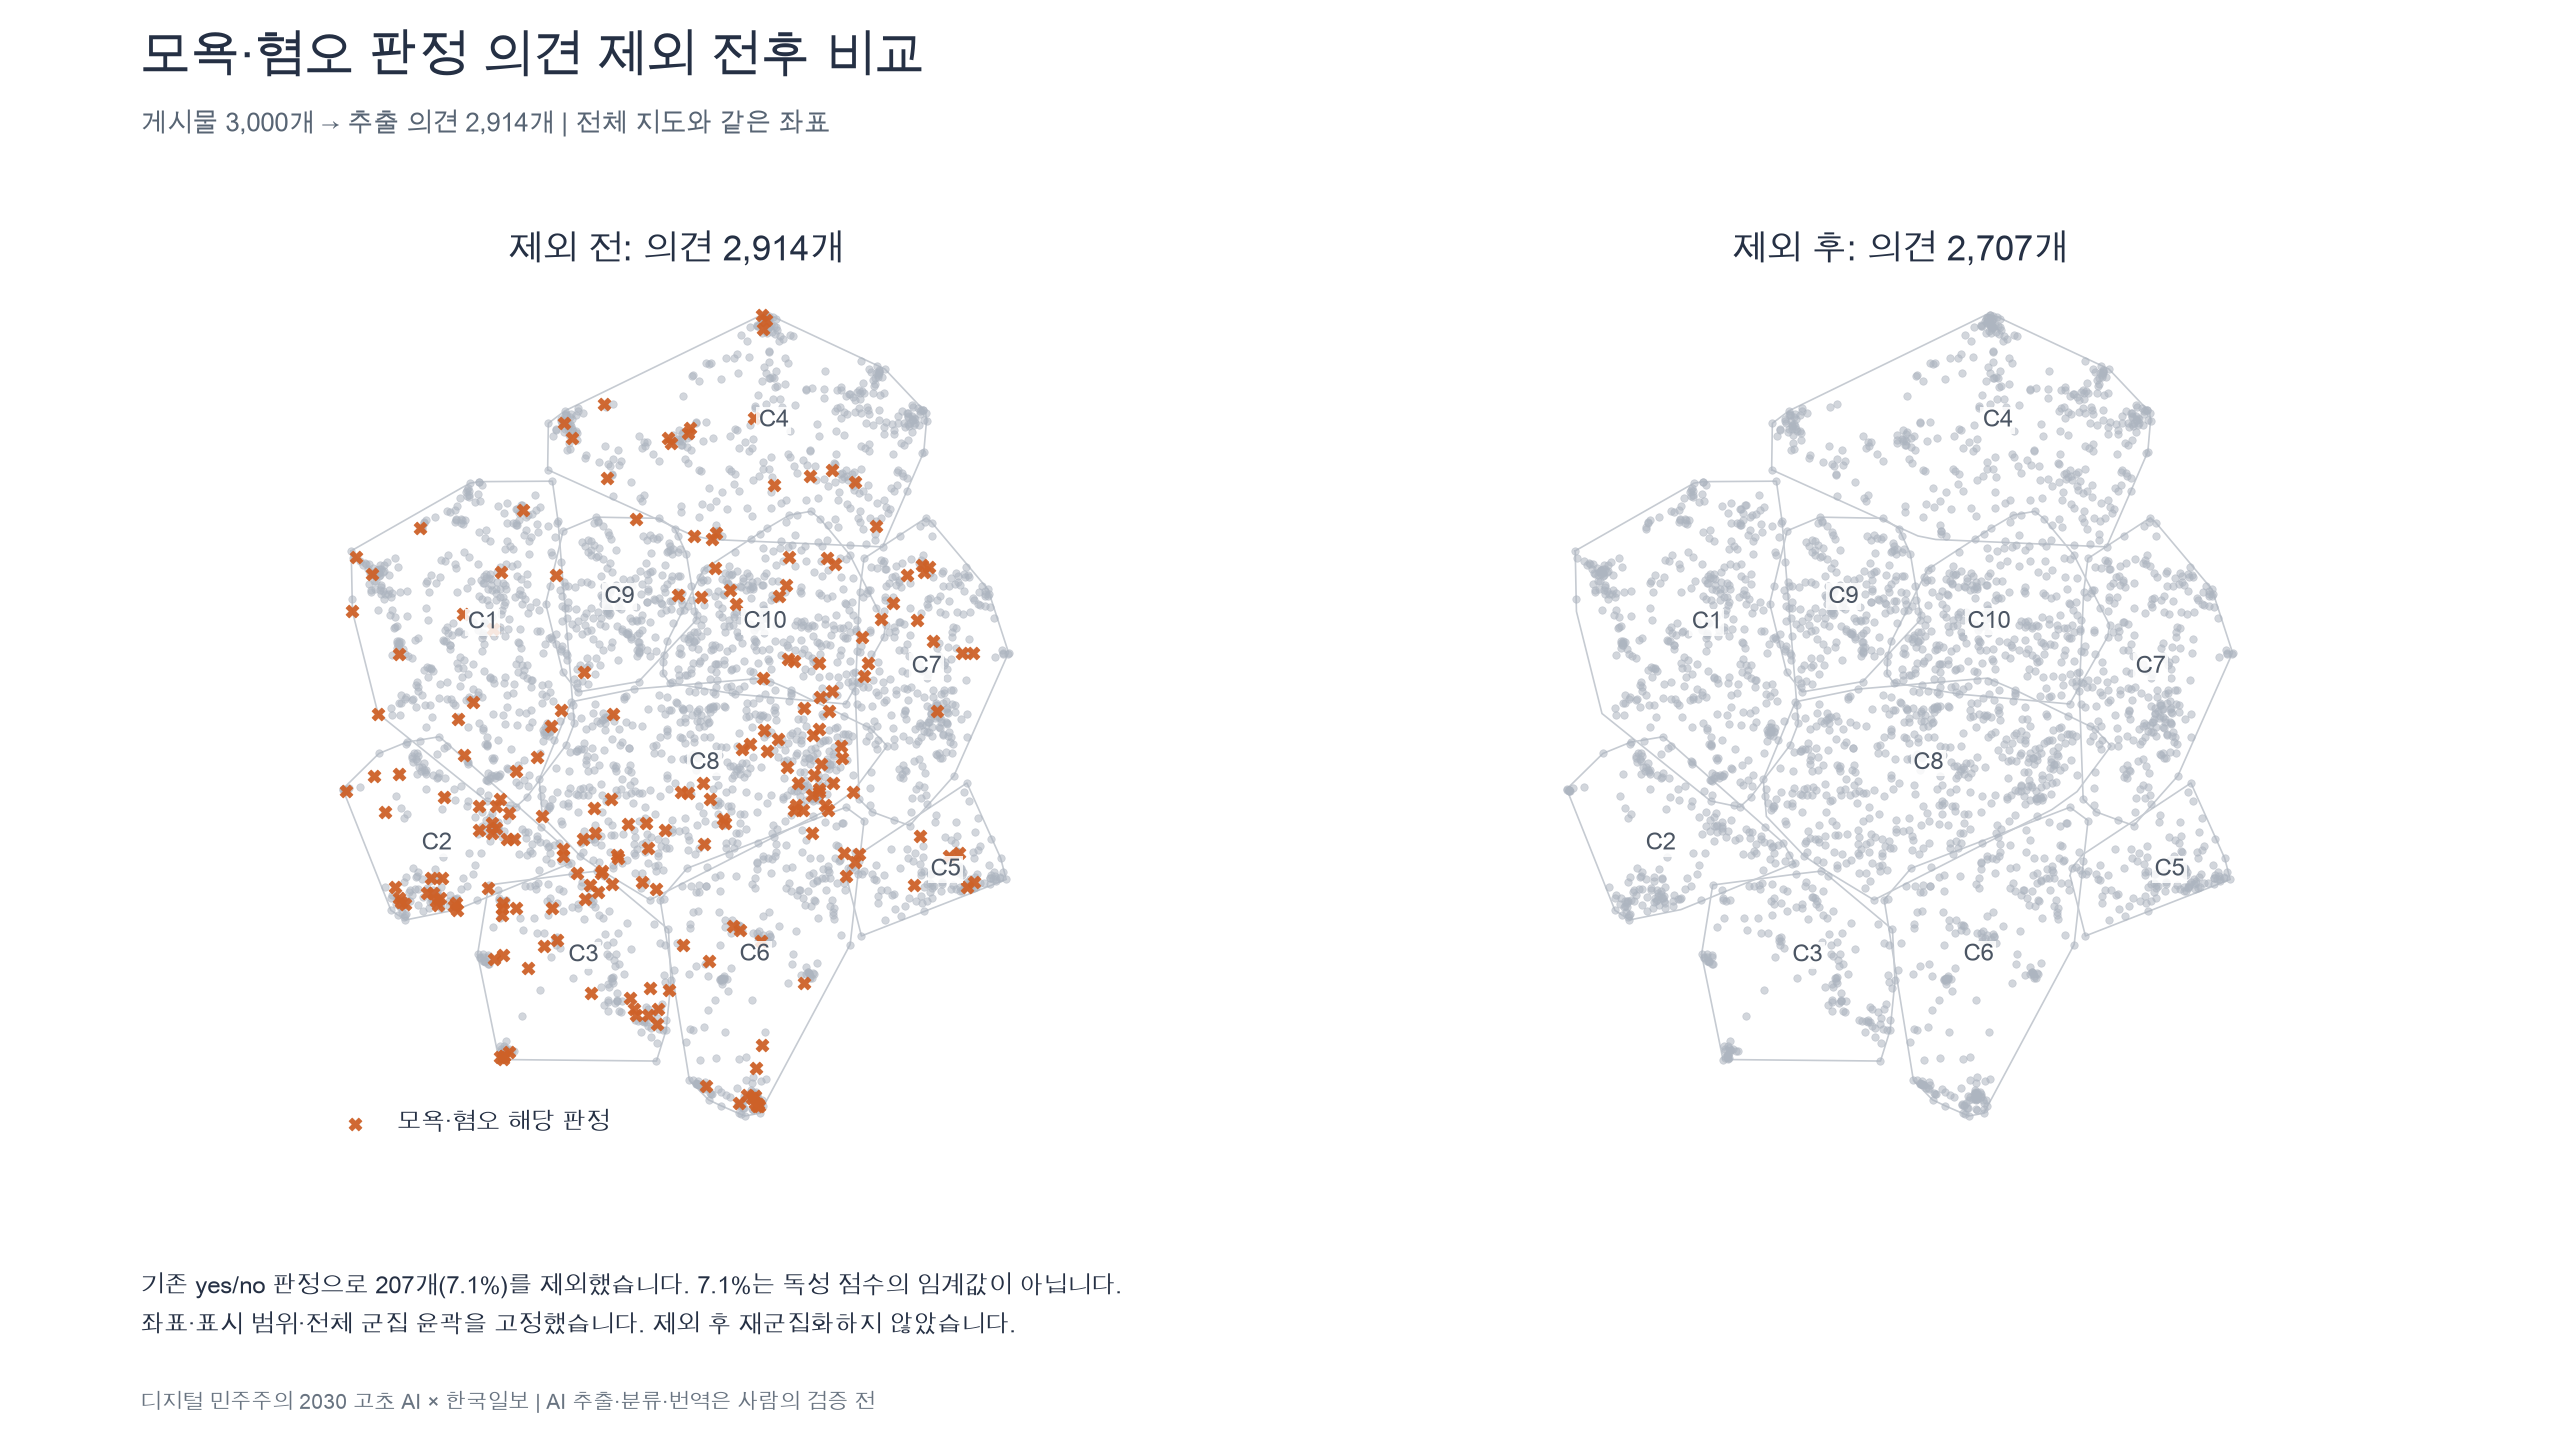
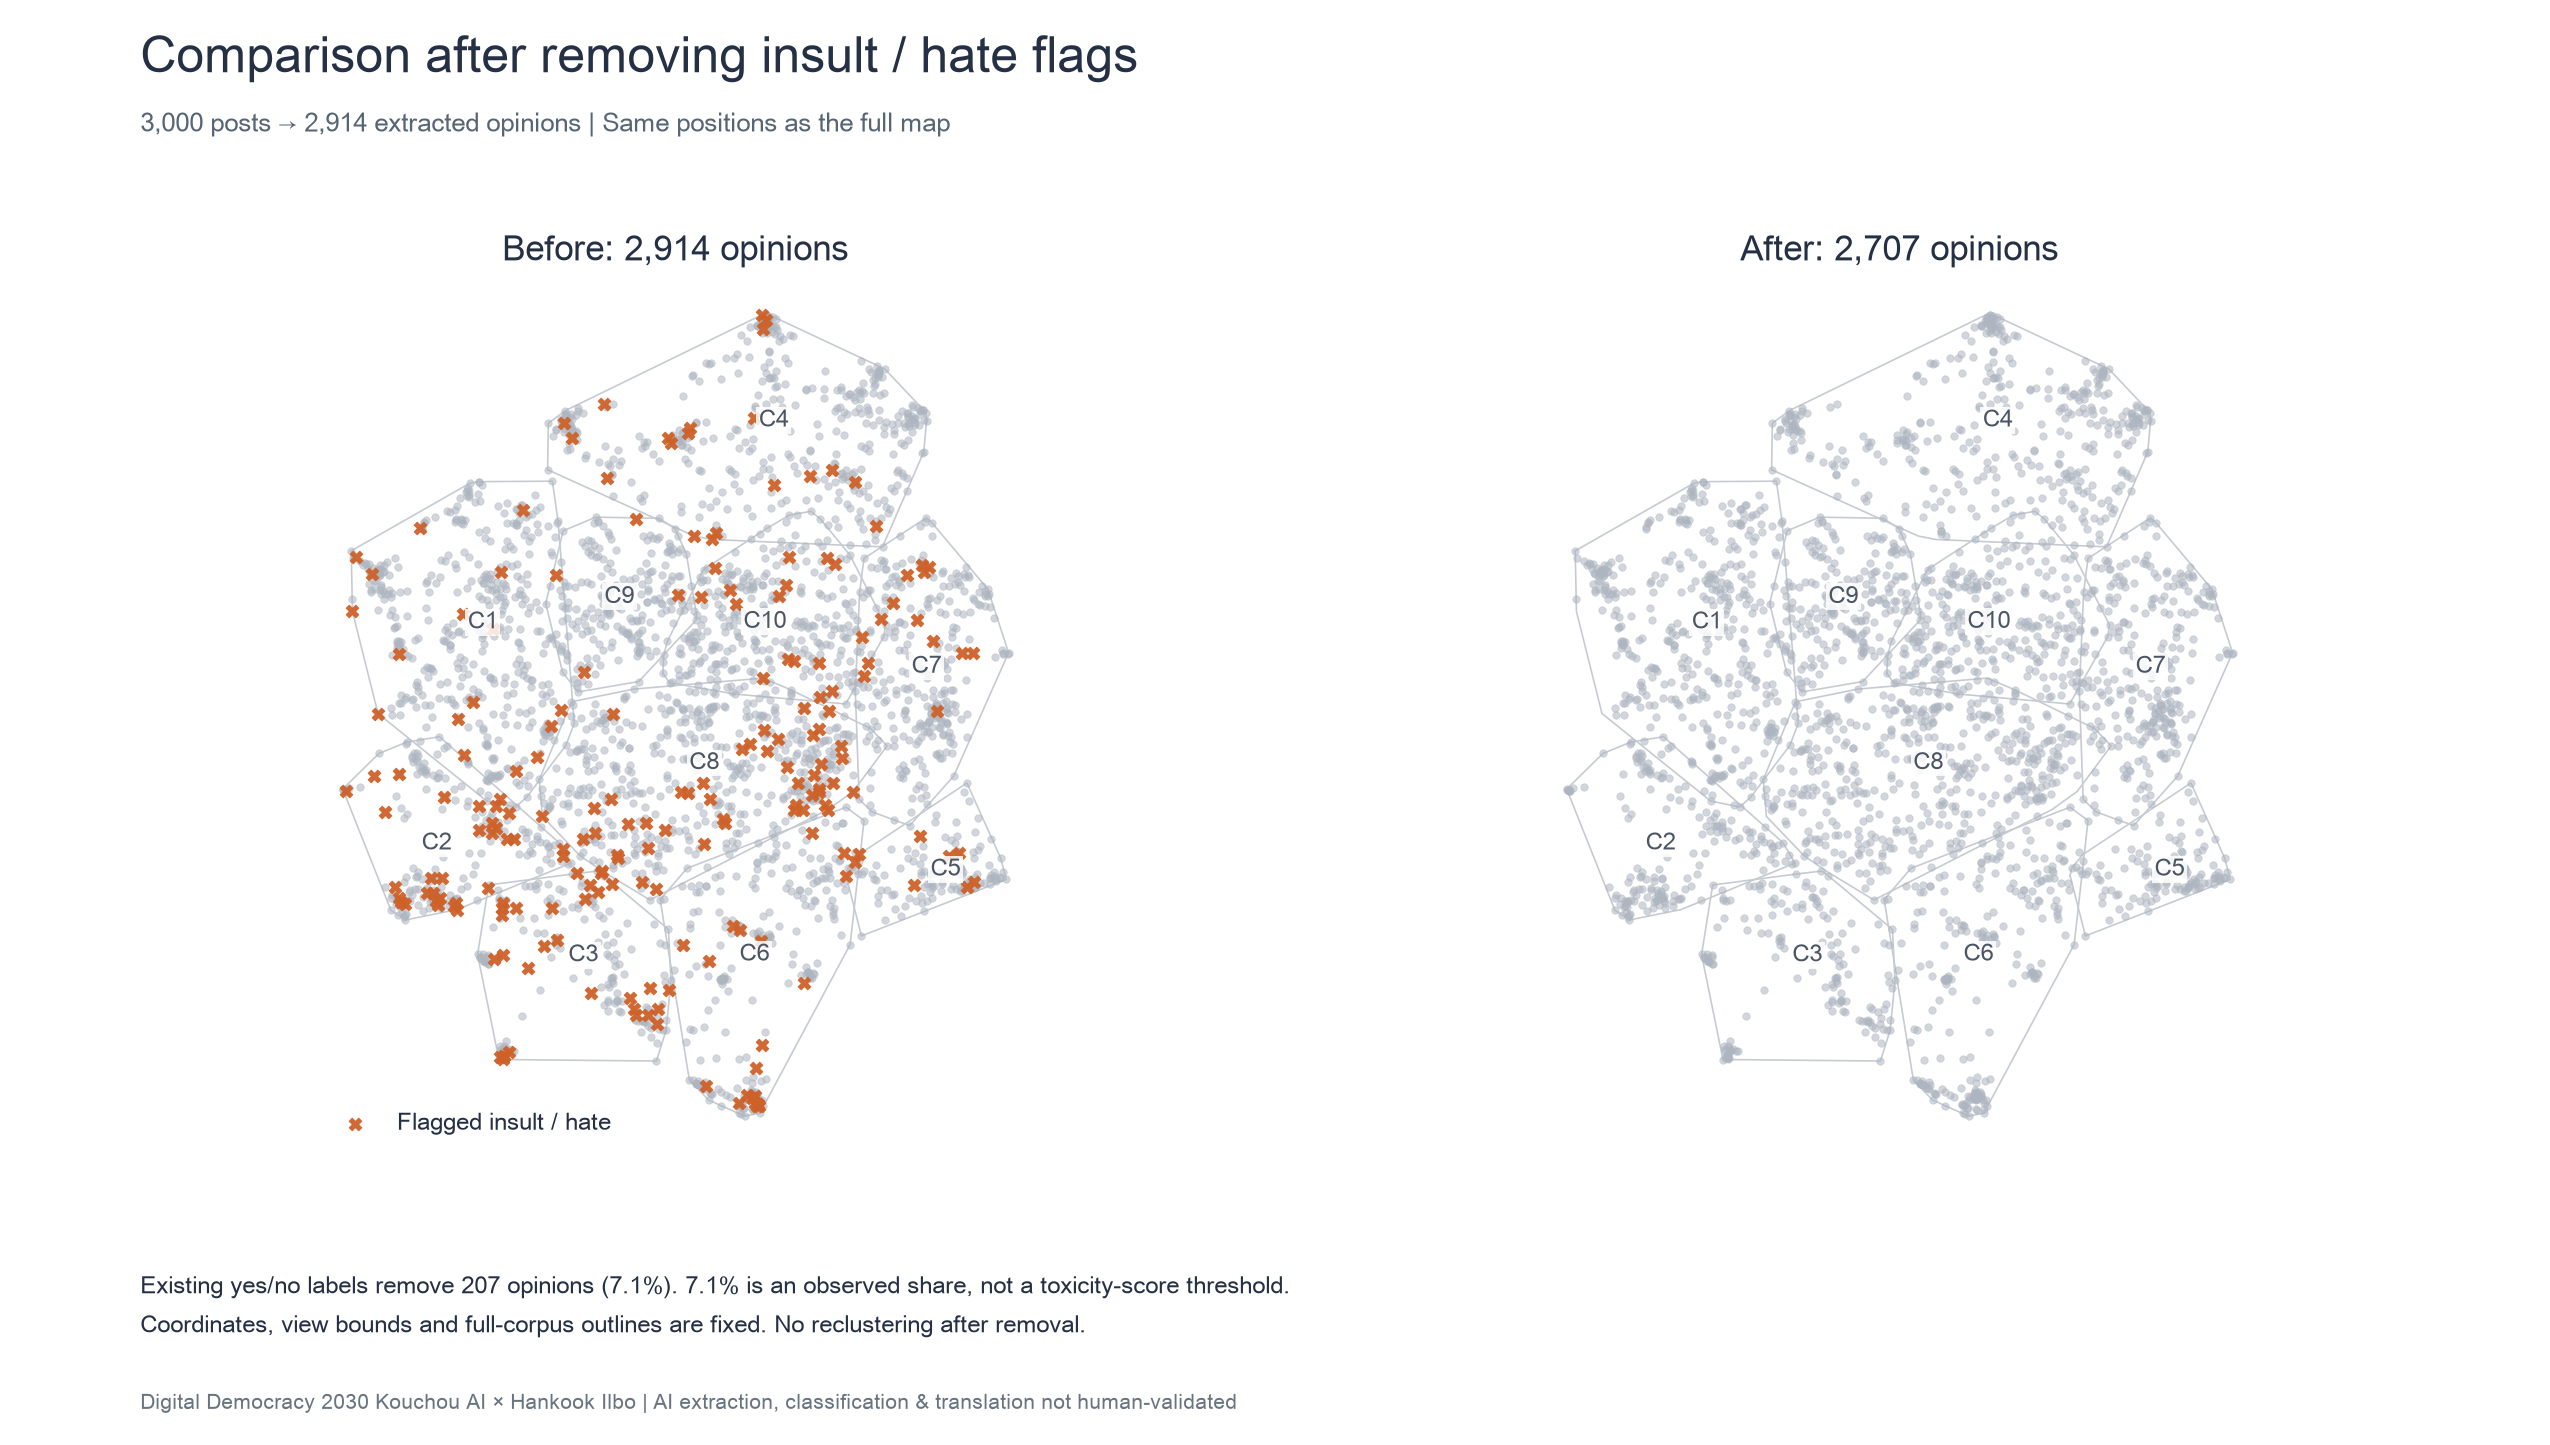
侮辱・ヘイトと判定された意見は7.1%
AIで、意見ごとに侮辱・ヘイト表現にあたるかを判定すると、2,914件のうち207件(7.1%)でした。これらを消すのではなく、地図の上でどこにあるかが見えるようにしています。
政策につながる意見は少ないが、ある
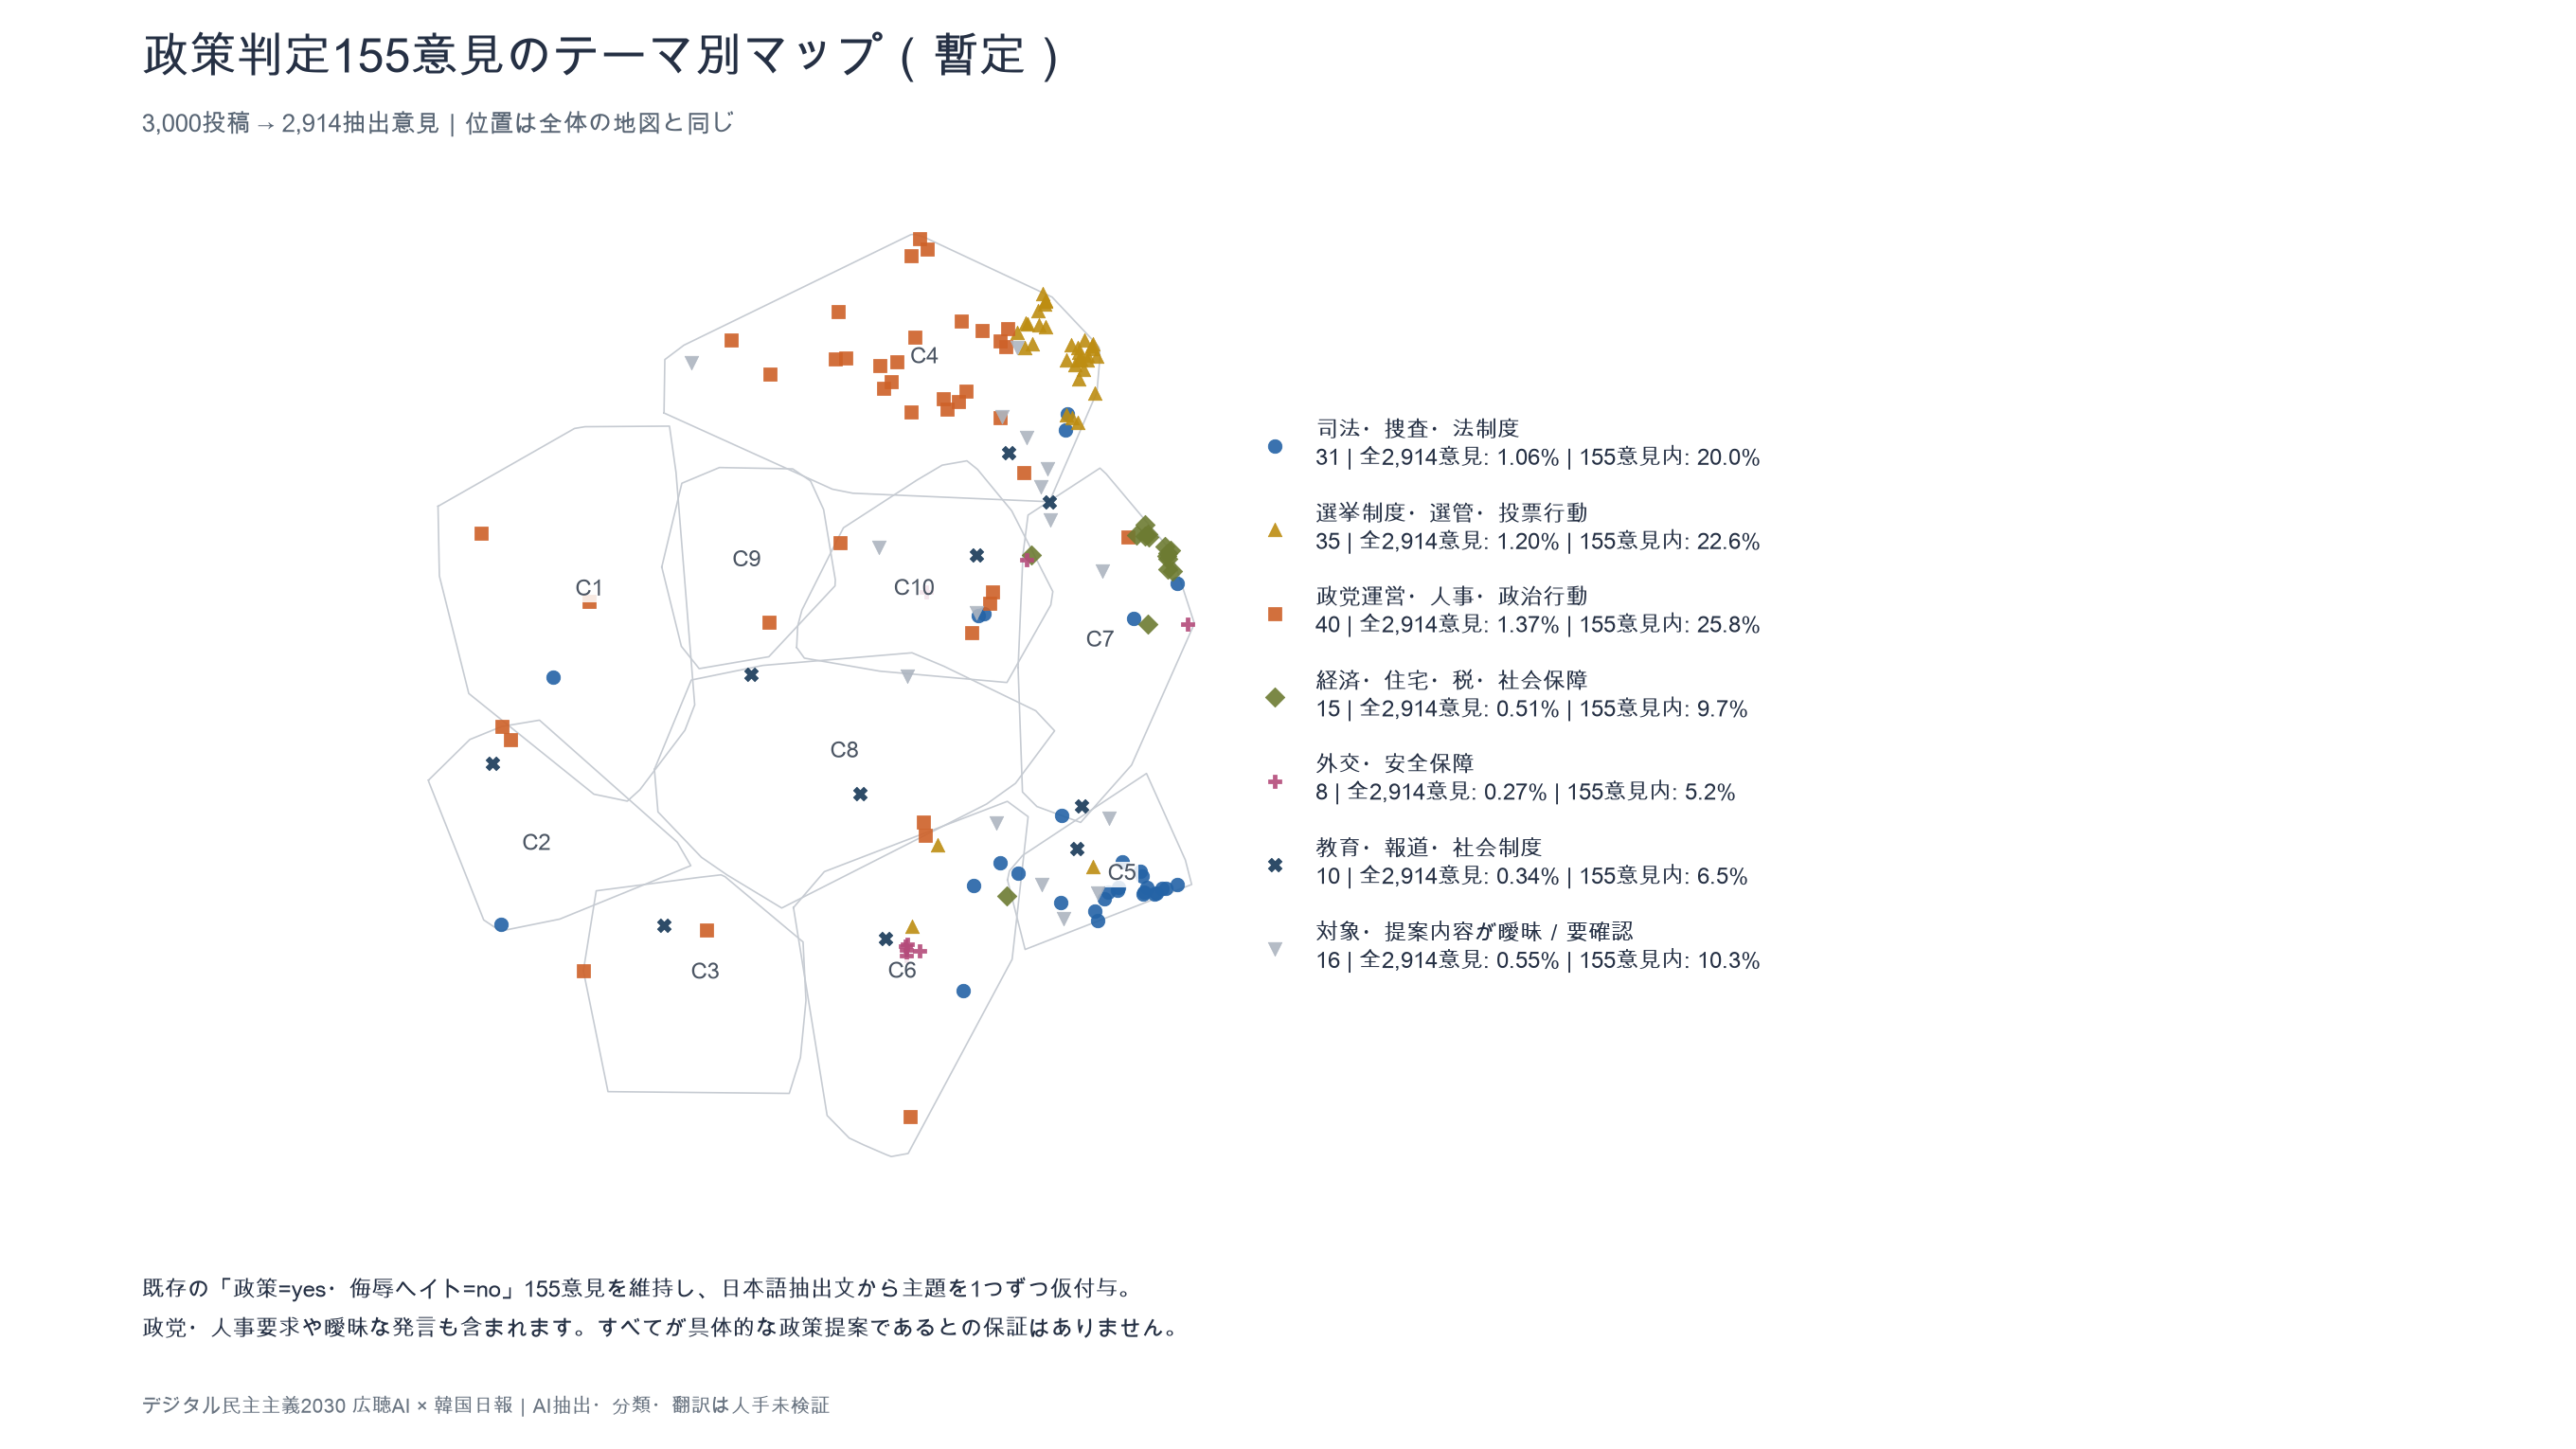
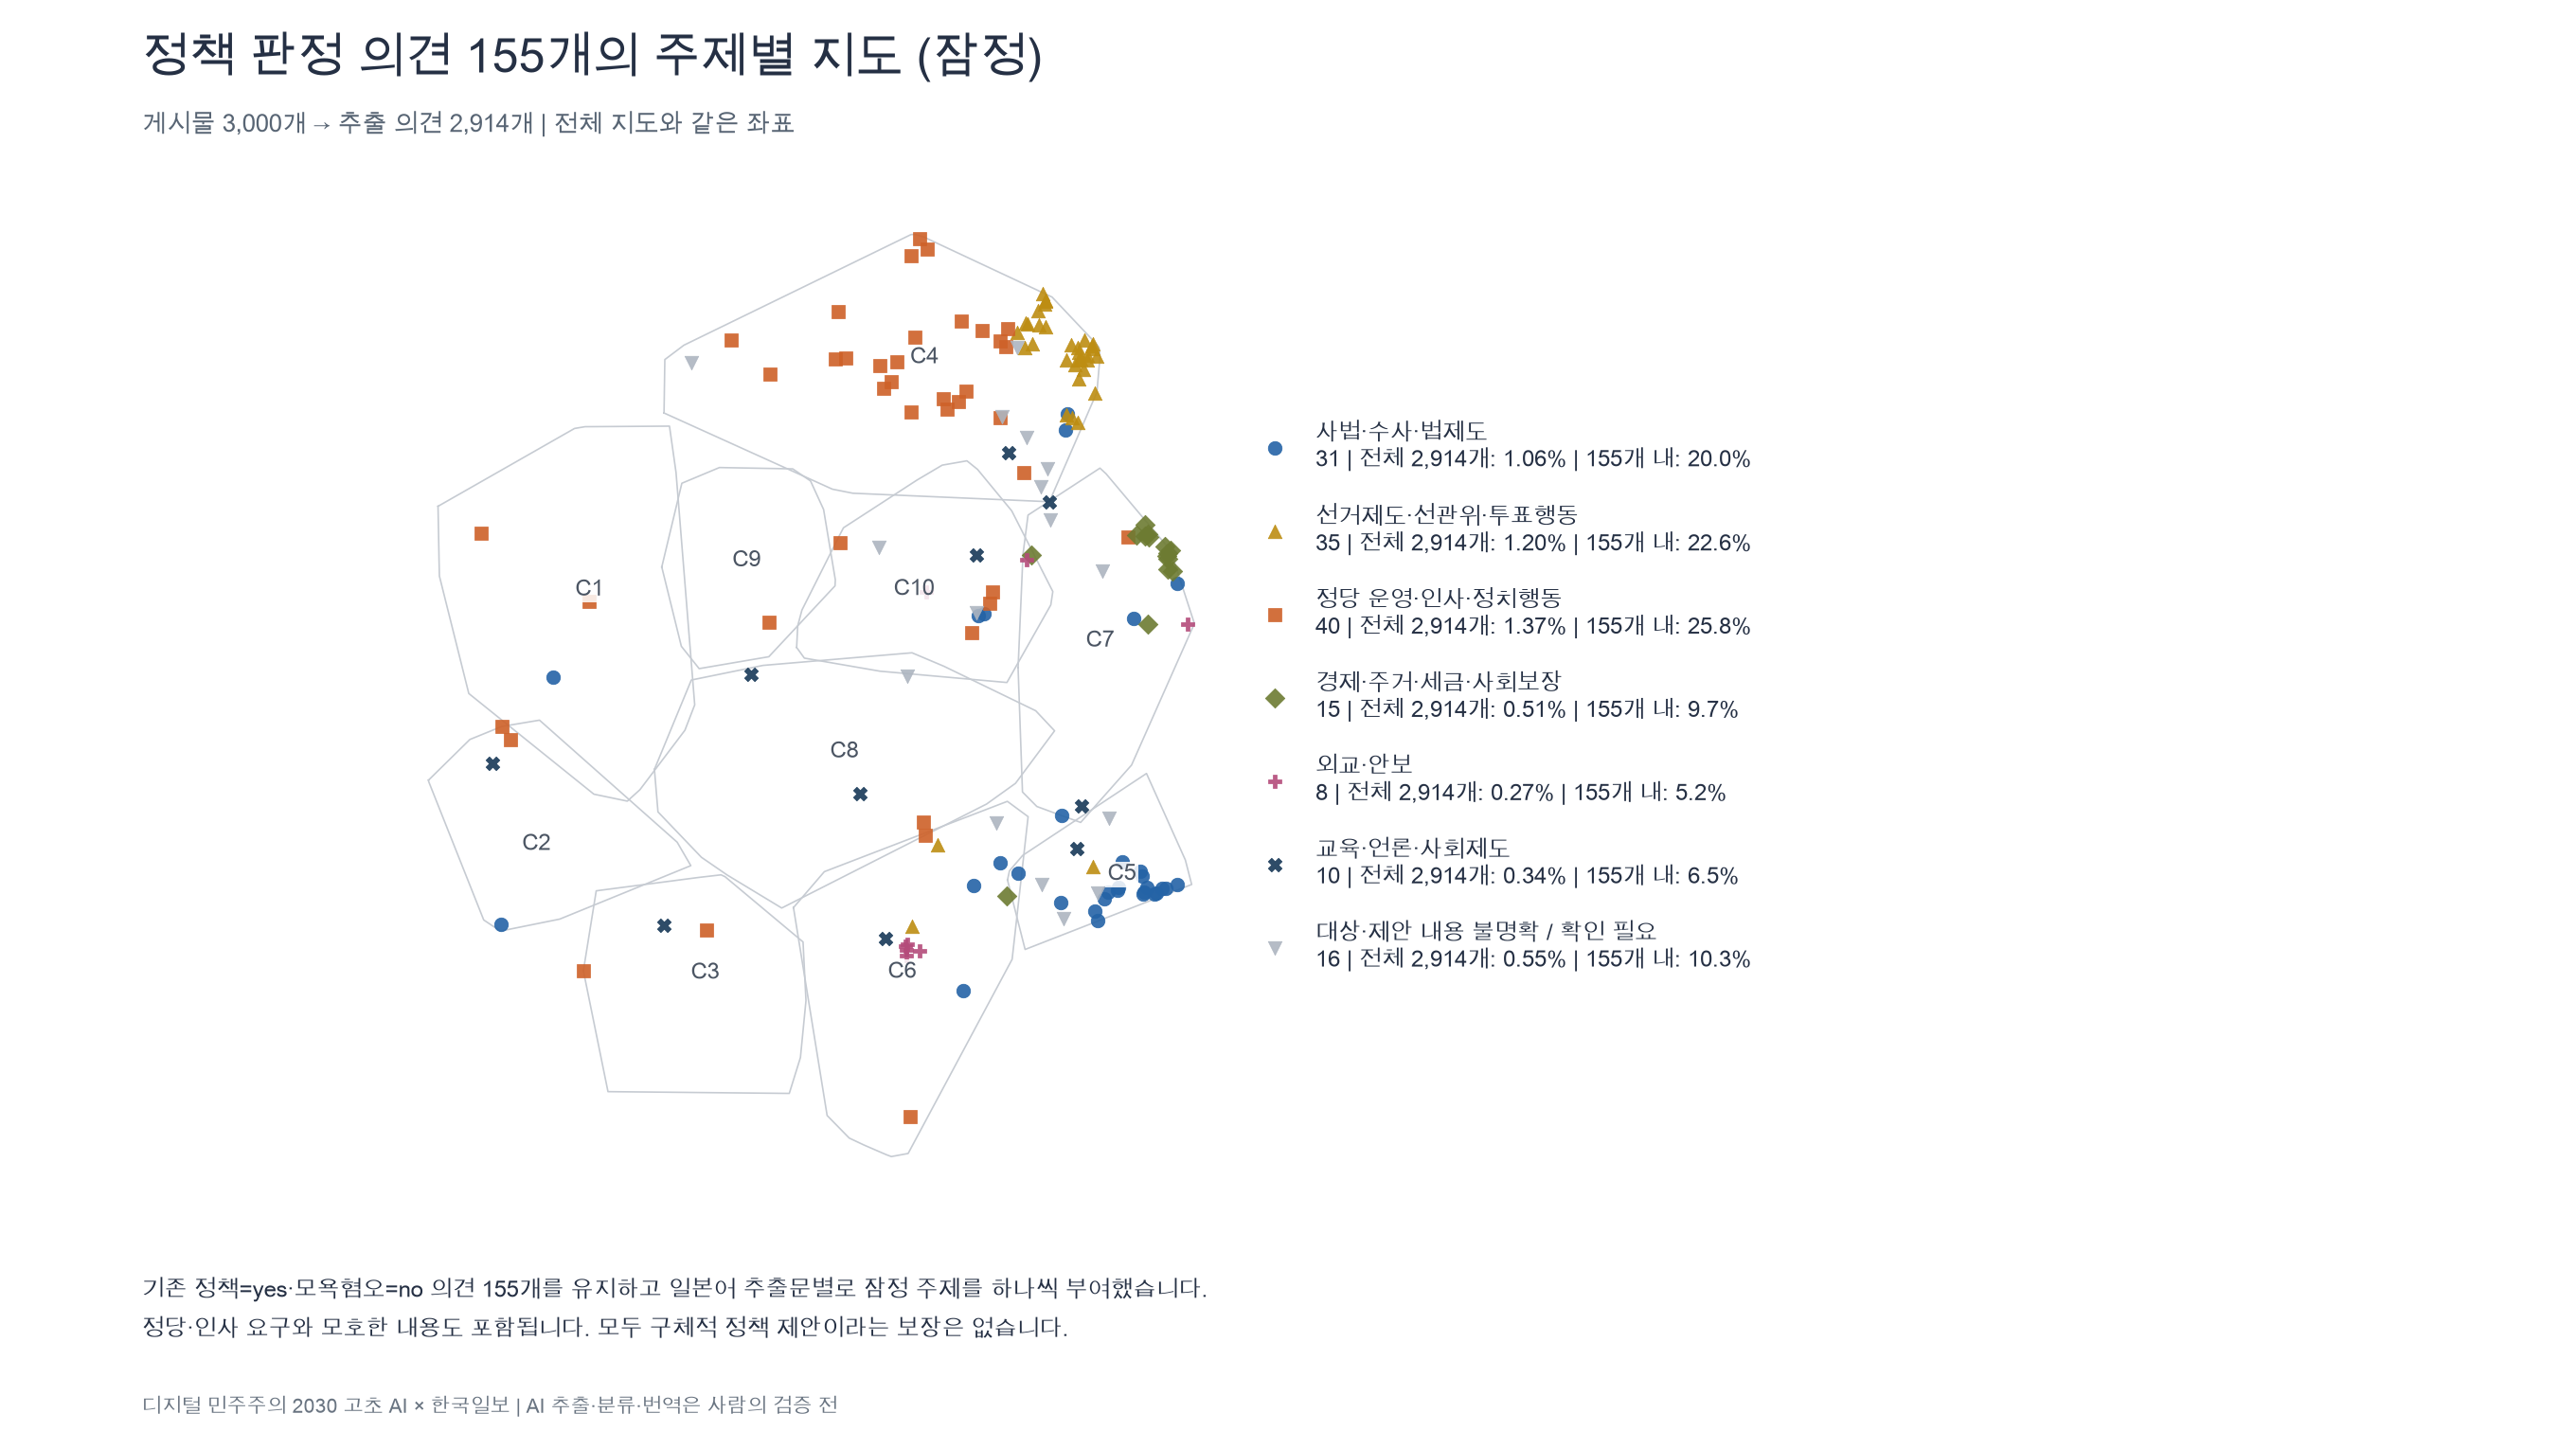
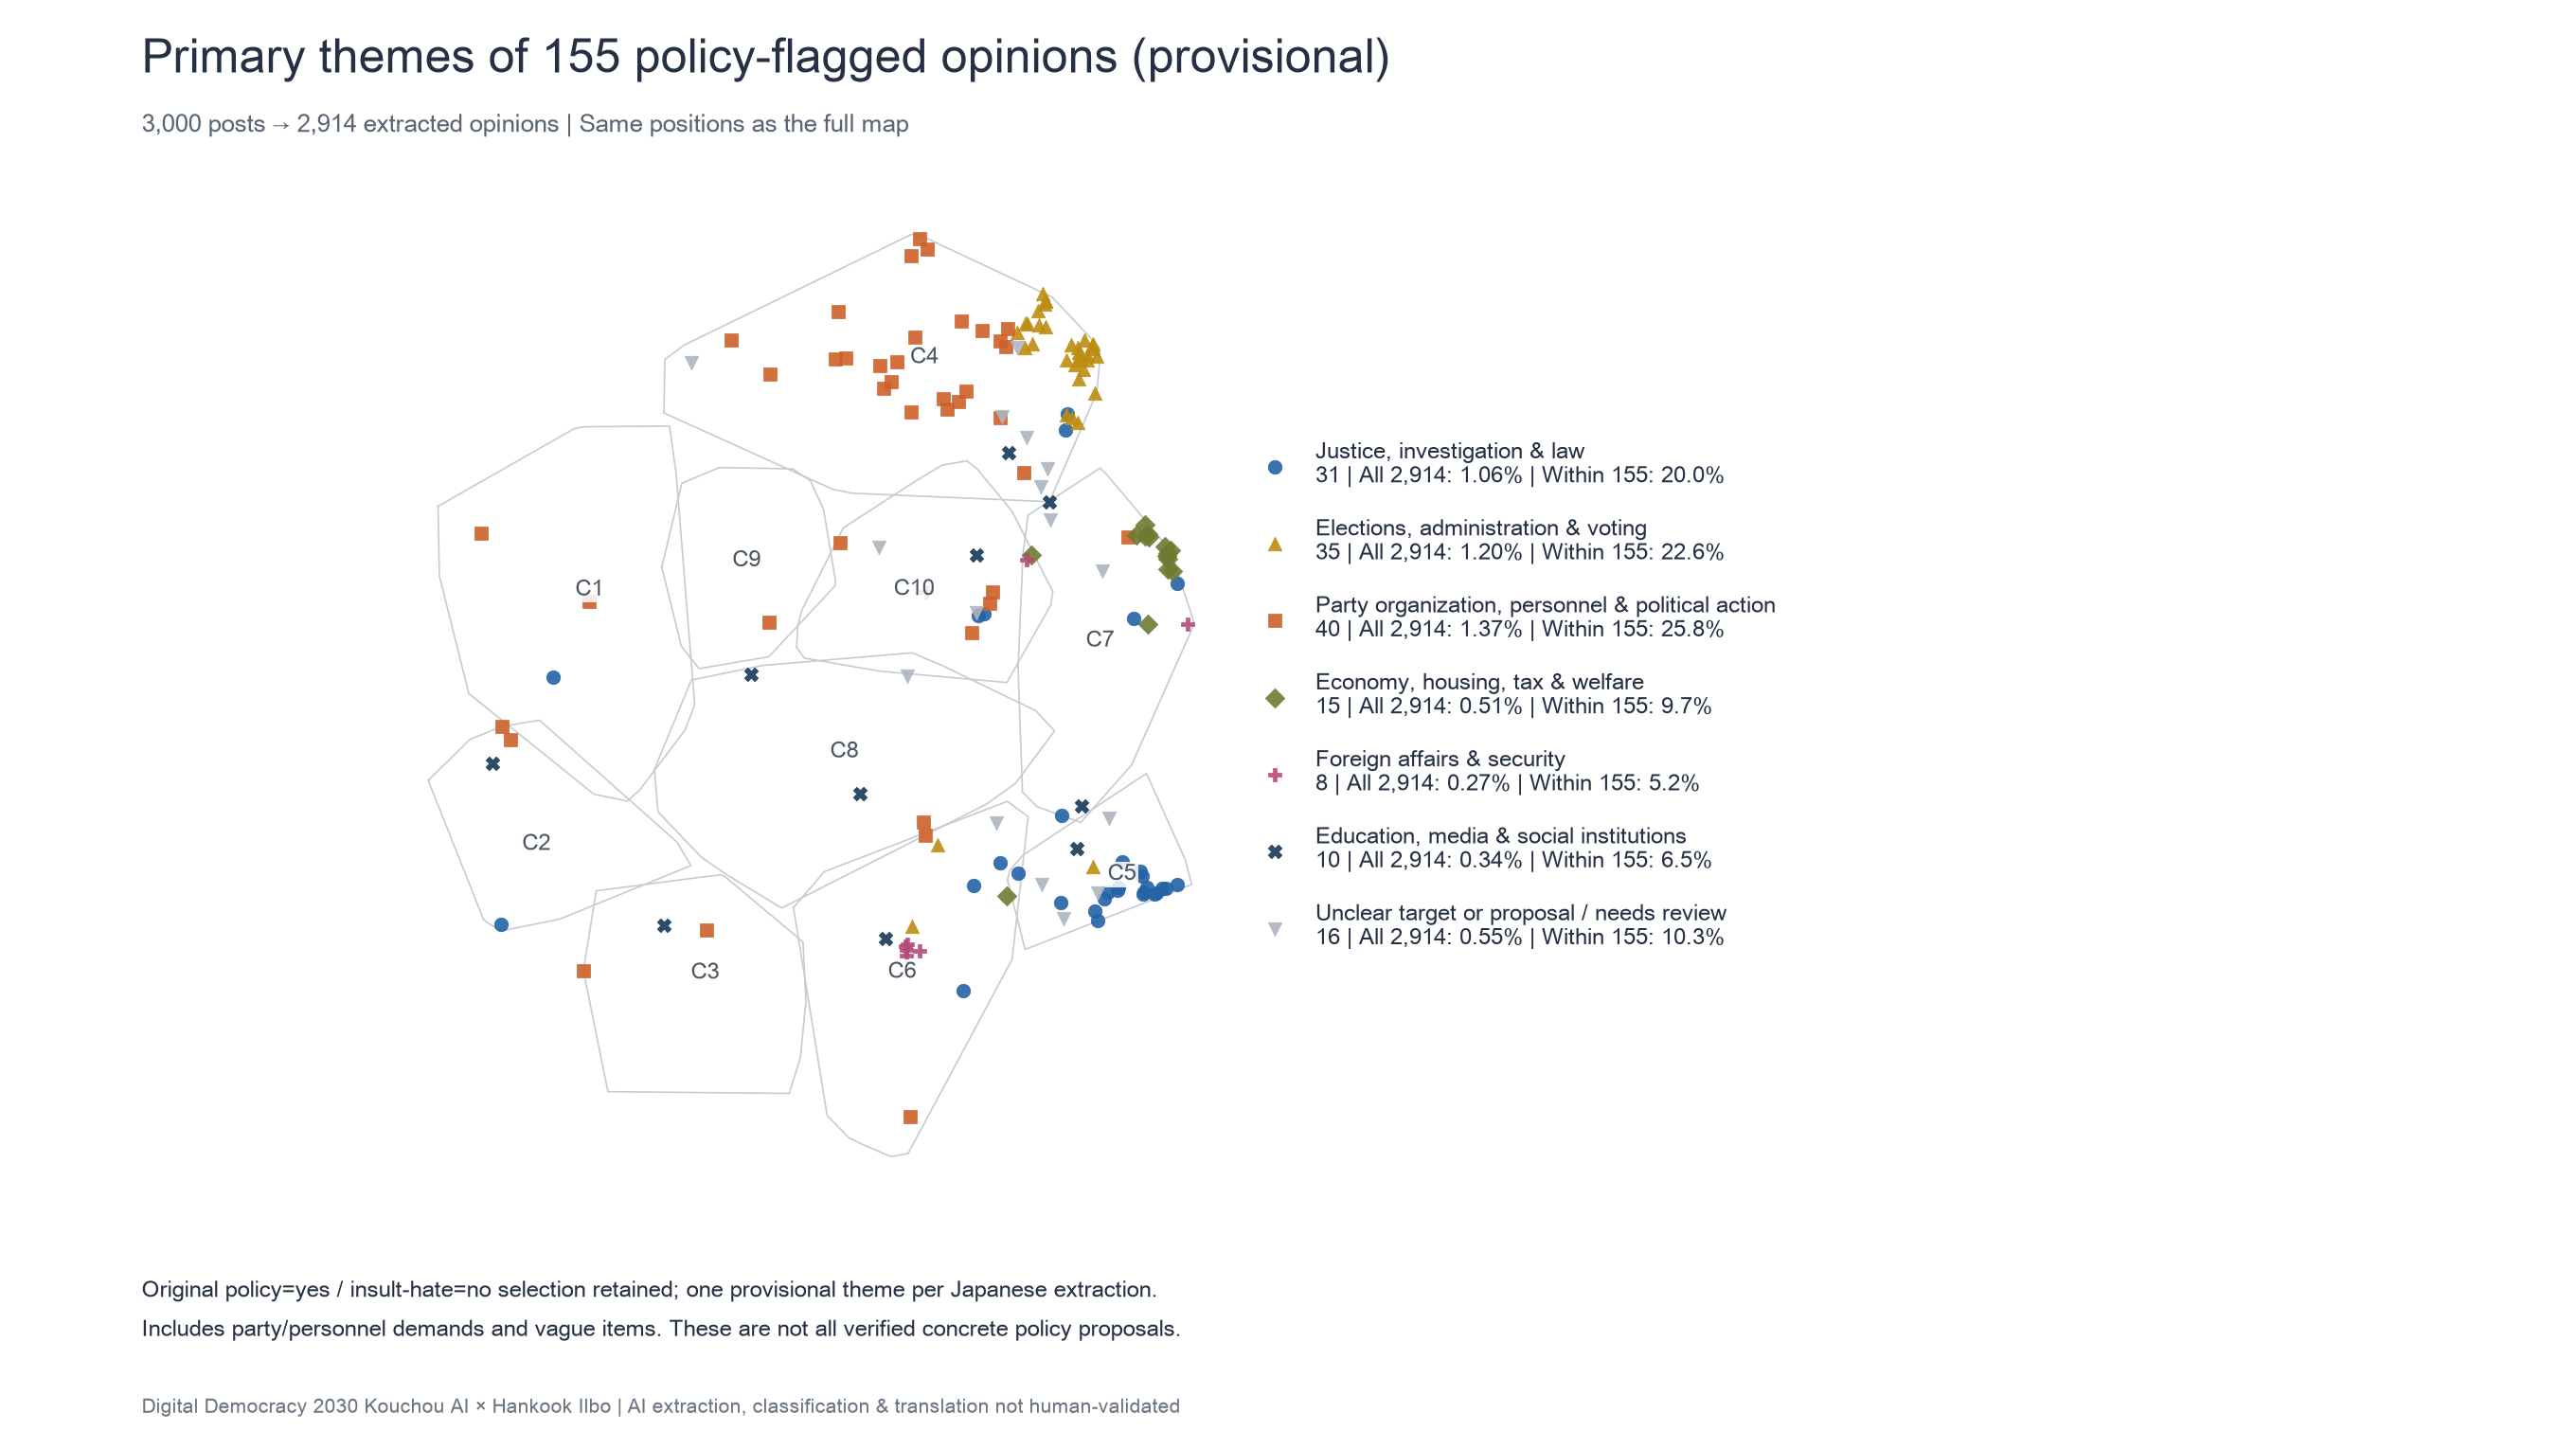
AIが政策・制度への提案と判定し、侮辱・ヘイトとは判定しなかった意見は155件(5.3%)でした。司法・捜査、選挙制度、政党運営、経済・住宅・税などに分かれます。テーマは日本語の抽出文から仮に付けたもので、政党や人事への要求、あいまいな発言も含みます。
読むときの注意
- 3,000件はチャンネルごとに同じ数を選んだもので、チャット全体や世論を代表する標本ではありません。点の数は人数や支持率ではありません。
- 群名・説明・抽出文・判定はAIによるもので、誤りを含みえます。たとえば、群名が中身と合っていない群もありました。
- 意見の抽出は日本語で行い、英語・韓国語はその機械翻訳です。韓国語話者による確認はしていません。
- 地図の縦軸・横軸に意味はありません。近い点ほど内容が似ている、という以上の意味は配置にありません。
- データ提供元の条件により、元のチャット本文と原文へのリンクは掲載していません。
方法
広聴AIで、gpt-4.1により各チャットから意見を日本語の文として抽出し、text-embedding-3-small でベクトルにしました。UMAPで2次元に配置し、k-meansで100群に分けたうえでWard法で10群にまとめ、群名と説明をLLMで生成しました。侮辱・ヘイトと政策提案の判定は、日本語の抽出文に対するAIのyes/no判定で、人による検証はしていません。英語・韓国語への翻訳はローカルで動かしたGemma 4 12B系のモデルで行いました。