한국 정치 유튜브 채팅을 고초 AI(広聴AI)로 분석하다 (한국일보)
한국일보의 기획 「유튜브 부족주의」 취재에서, 한국일보가 수집한 한국 정치 유튜브 6개 채널의 실시간 채팅을 니시오 히로카즈(디지털 민주주의 2030)가 고초 AI(広聴AI)로 분석했습니다. 결과는 2026년 10월 22일 기사 2건으로 소개되었습니다. 이 페이지에서는 그 분석 결과를 공개합니다.
유튜브 채팅도 '진영' 떼고 묶으면 달리 보인다? '시민 목소리' 찾는 日엔지니어 한국일보 2026년 10월 22일
2026년 10월 8일에 진행한 니시오 히로카즈 인터뷰 기사입니다. 고초 AI로 한국 정치 유튜브의 채팅을 시각화해, 입장이 정반대인 의견도 같은 주제라면 하나의 덩어리가 된다는 점과, 진영 대립에 가려진 시민의 관심사를 찾는 관점을 소개합니다. 코드 포 재팬의 활동도 함께 다룹니다.
기사 읽기 (새 탭) →한국 정치 유튜브, 공론장으로 낙제점?… 일본 엔지니어의 진단은 한국일보 2026년 10월 22일
정치 유튜브 6개 채널의 채팅을 니시오 히로카즈와 고초 AI로 분석한 결과를 전하는 기사입니다. 특정 정치인에 대한 지지와 비난, 상대 진영의 배제를 요구하는 목소리가 많았고 정책으로 이어질 논의는 적었지만, 어느 한 진영만 차지한 주제는 없었습니다. 또한 한 플랫폼의 목소리를 여론 전체로 보지 않고 여러 경로로 의견을 모아야 할 필요성을 다룹니다.
기사 읽기 (새 탭) →분석한 데이터
진보 성향 3개 채널(김어준의 뉴스공장, 매불쇼, 이동형TV)과 보수 성향 3개 채널(고성국TV, 배승희 변호사, 신의한수)의 2026년 1~8월 실시간 채팅에서 채널별로 500건씩, 모두 3,000건을 골랐습니다. 진보 성향·보수 성향은 채널에 대한 일반적인 분류이며, 게시자 본인의 입장을 나타내지 않습니다.
의견 지도
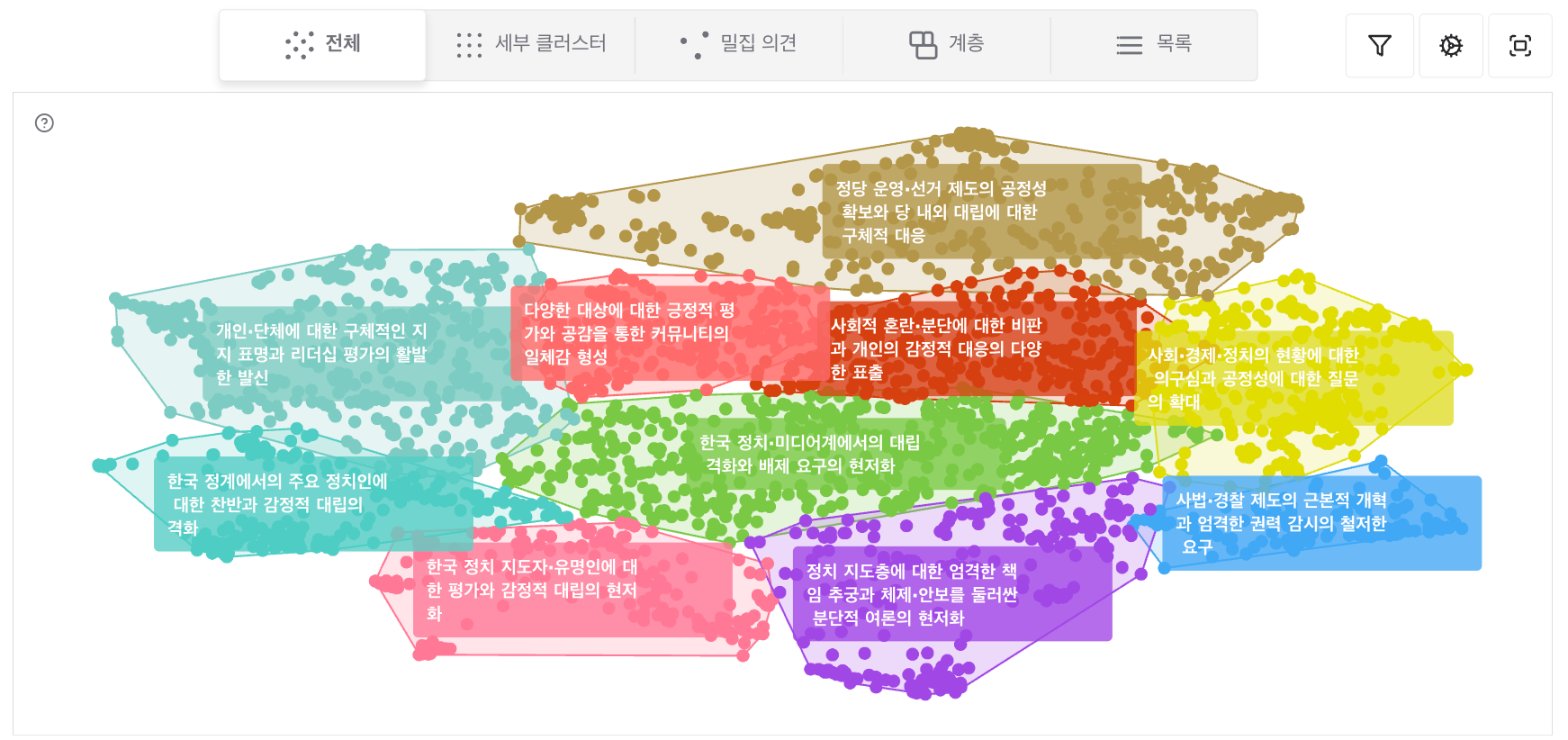
고초 AI로 만든 지도입니다. 점 하나는 추출된 의견 1건이며, 가까운 점일수록 내용이 비슷합니다. 각 지도 위쪽에서 日本語·English·한국어를 바꿀 수 있습니다.
채널별 지도(채널마다 따로 만들었기 때문에 다른 지도와 위치·그룹이 대응하지 않습니다):
알게 된 것
큰 주제는 양쪽 진영에 공통이었다
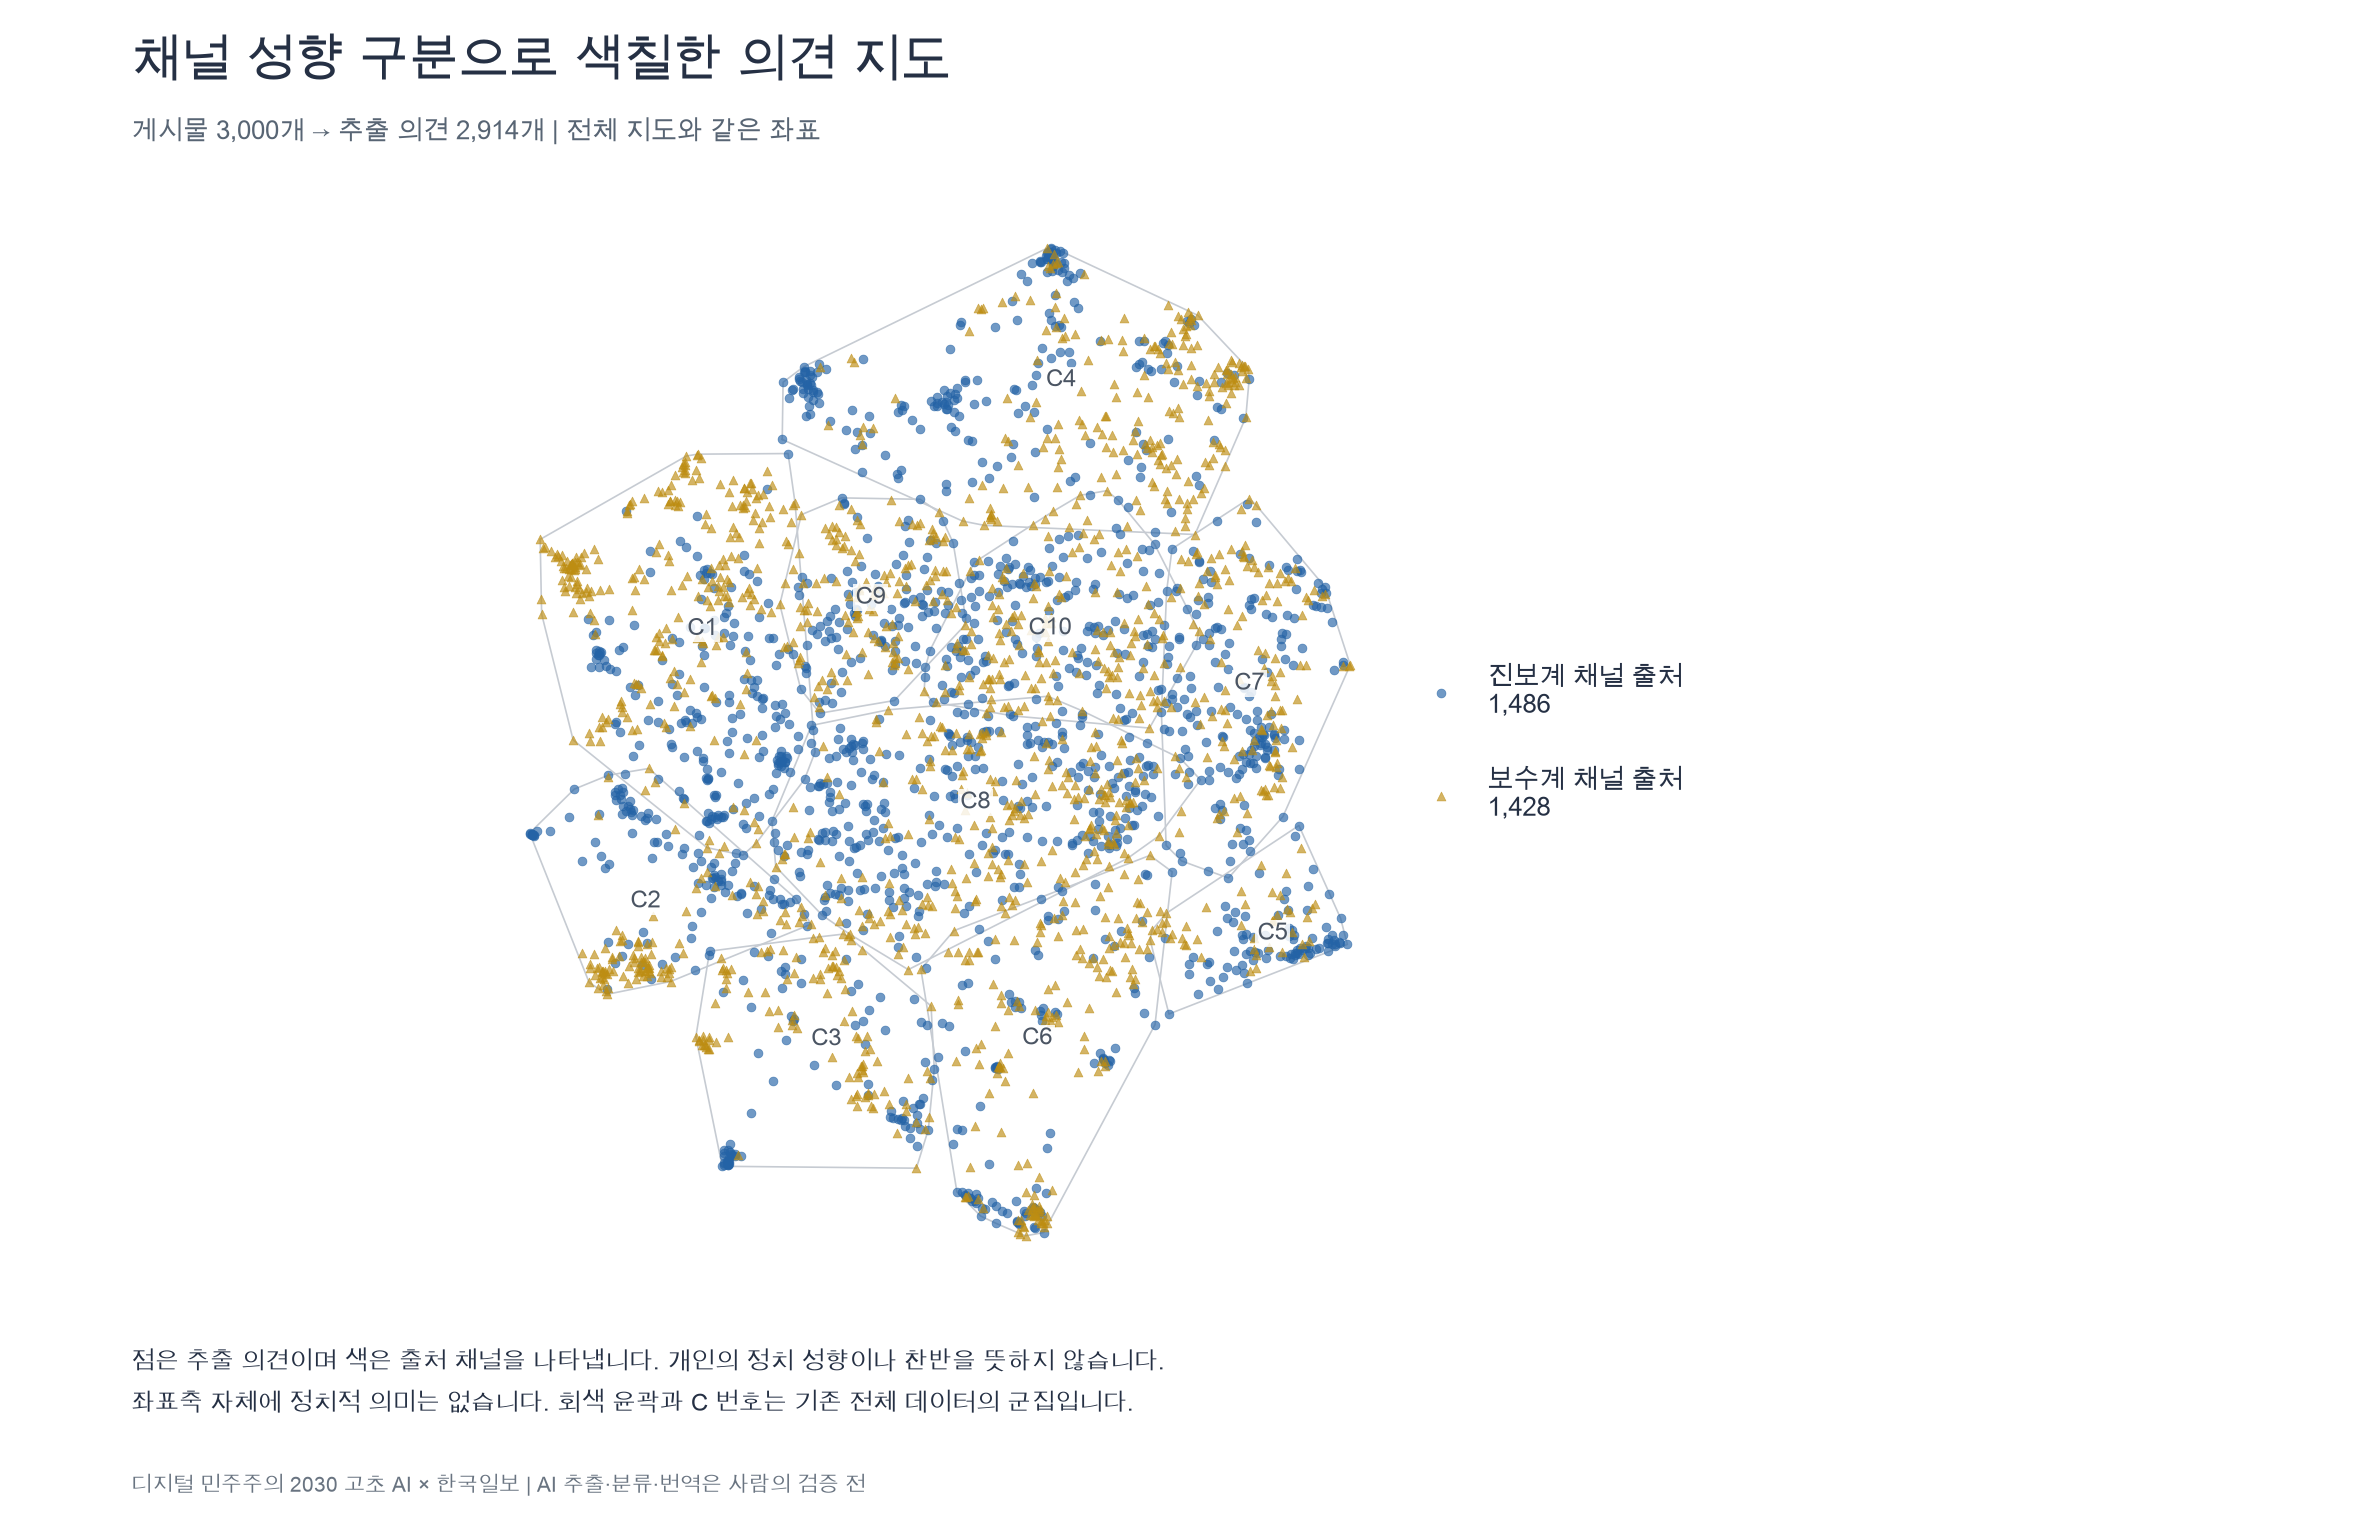
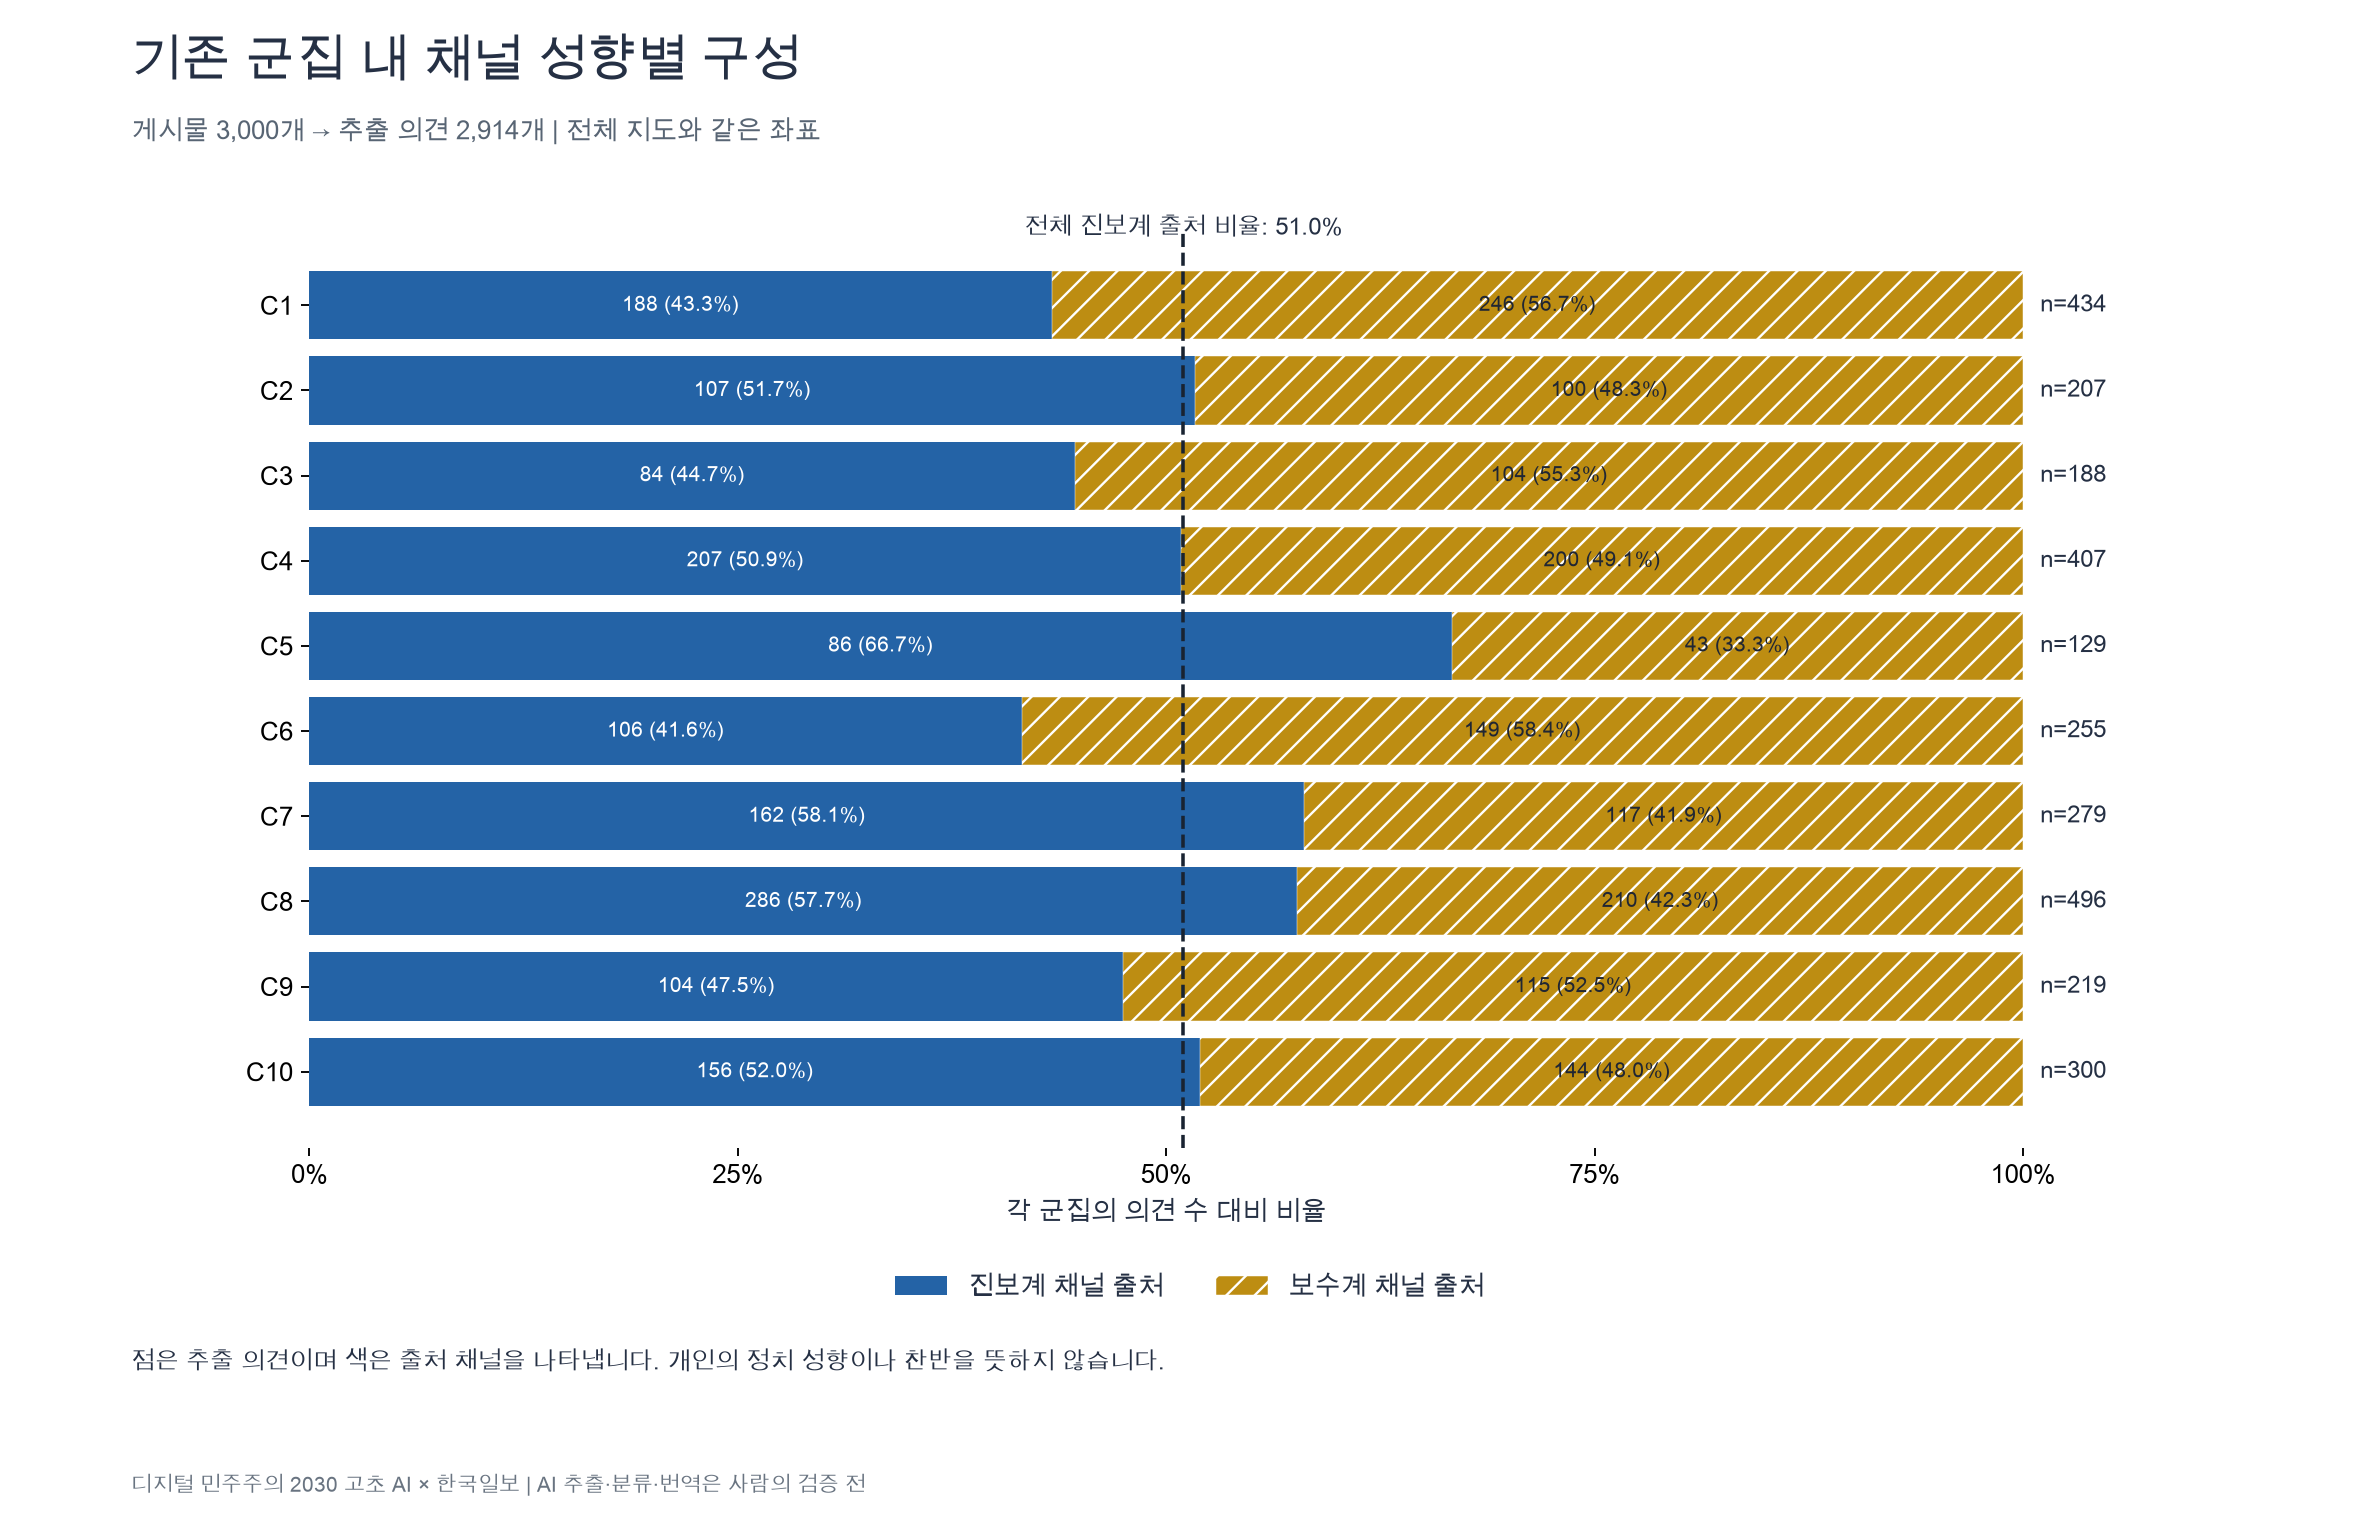
3,000건 중 2,663건에서 의견을 추출하고 같은 문장을 합쳐 의견 2,914건을 얻었습니다. 이를 10개 그룹으로 나누자 가장 큰 그룹은 '대립 격화와 배제 요구'(496건), 다음은 '개인·단체에 대한 지지 표명과 리더십 평가'(434건)였습니다. 10개 그룹 모두에서 진보 성향 채널에서 온 의견의 비율은 42~67% 사이였고(전체 51%), 어느 한 진영의 채널로만 이루어진 그룹은 없었습니다. 한쪽으로 크게 치우친 것은 더 작은 그룹들, 특정 인물에 관한 이야기였습니다.
같은 주제라면 입장이 반대여도 같은 그룹에 들어간다
고초 AI는 '누가 말했는가'가 아니라 '무엇에 대해 말했는가'로 의견을 묶습니다. 그래서 같은 주제에 대한 정반대 의견이 같은 그룹에 들어갑니다. 같은 그룹이라고 해서 입장까지 같은 것은 아닙니다. 찬반 비율은 산출하지 않았습니다.
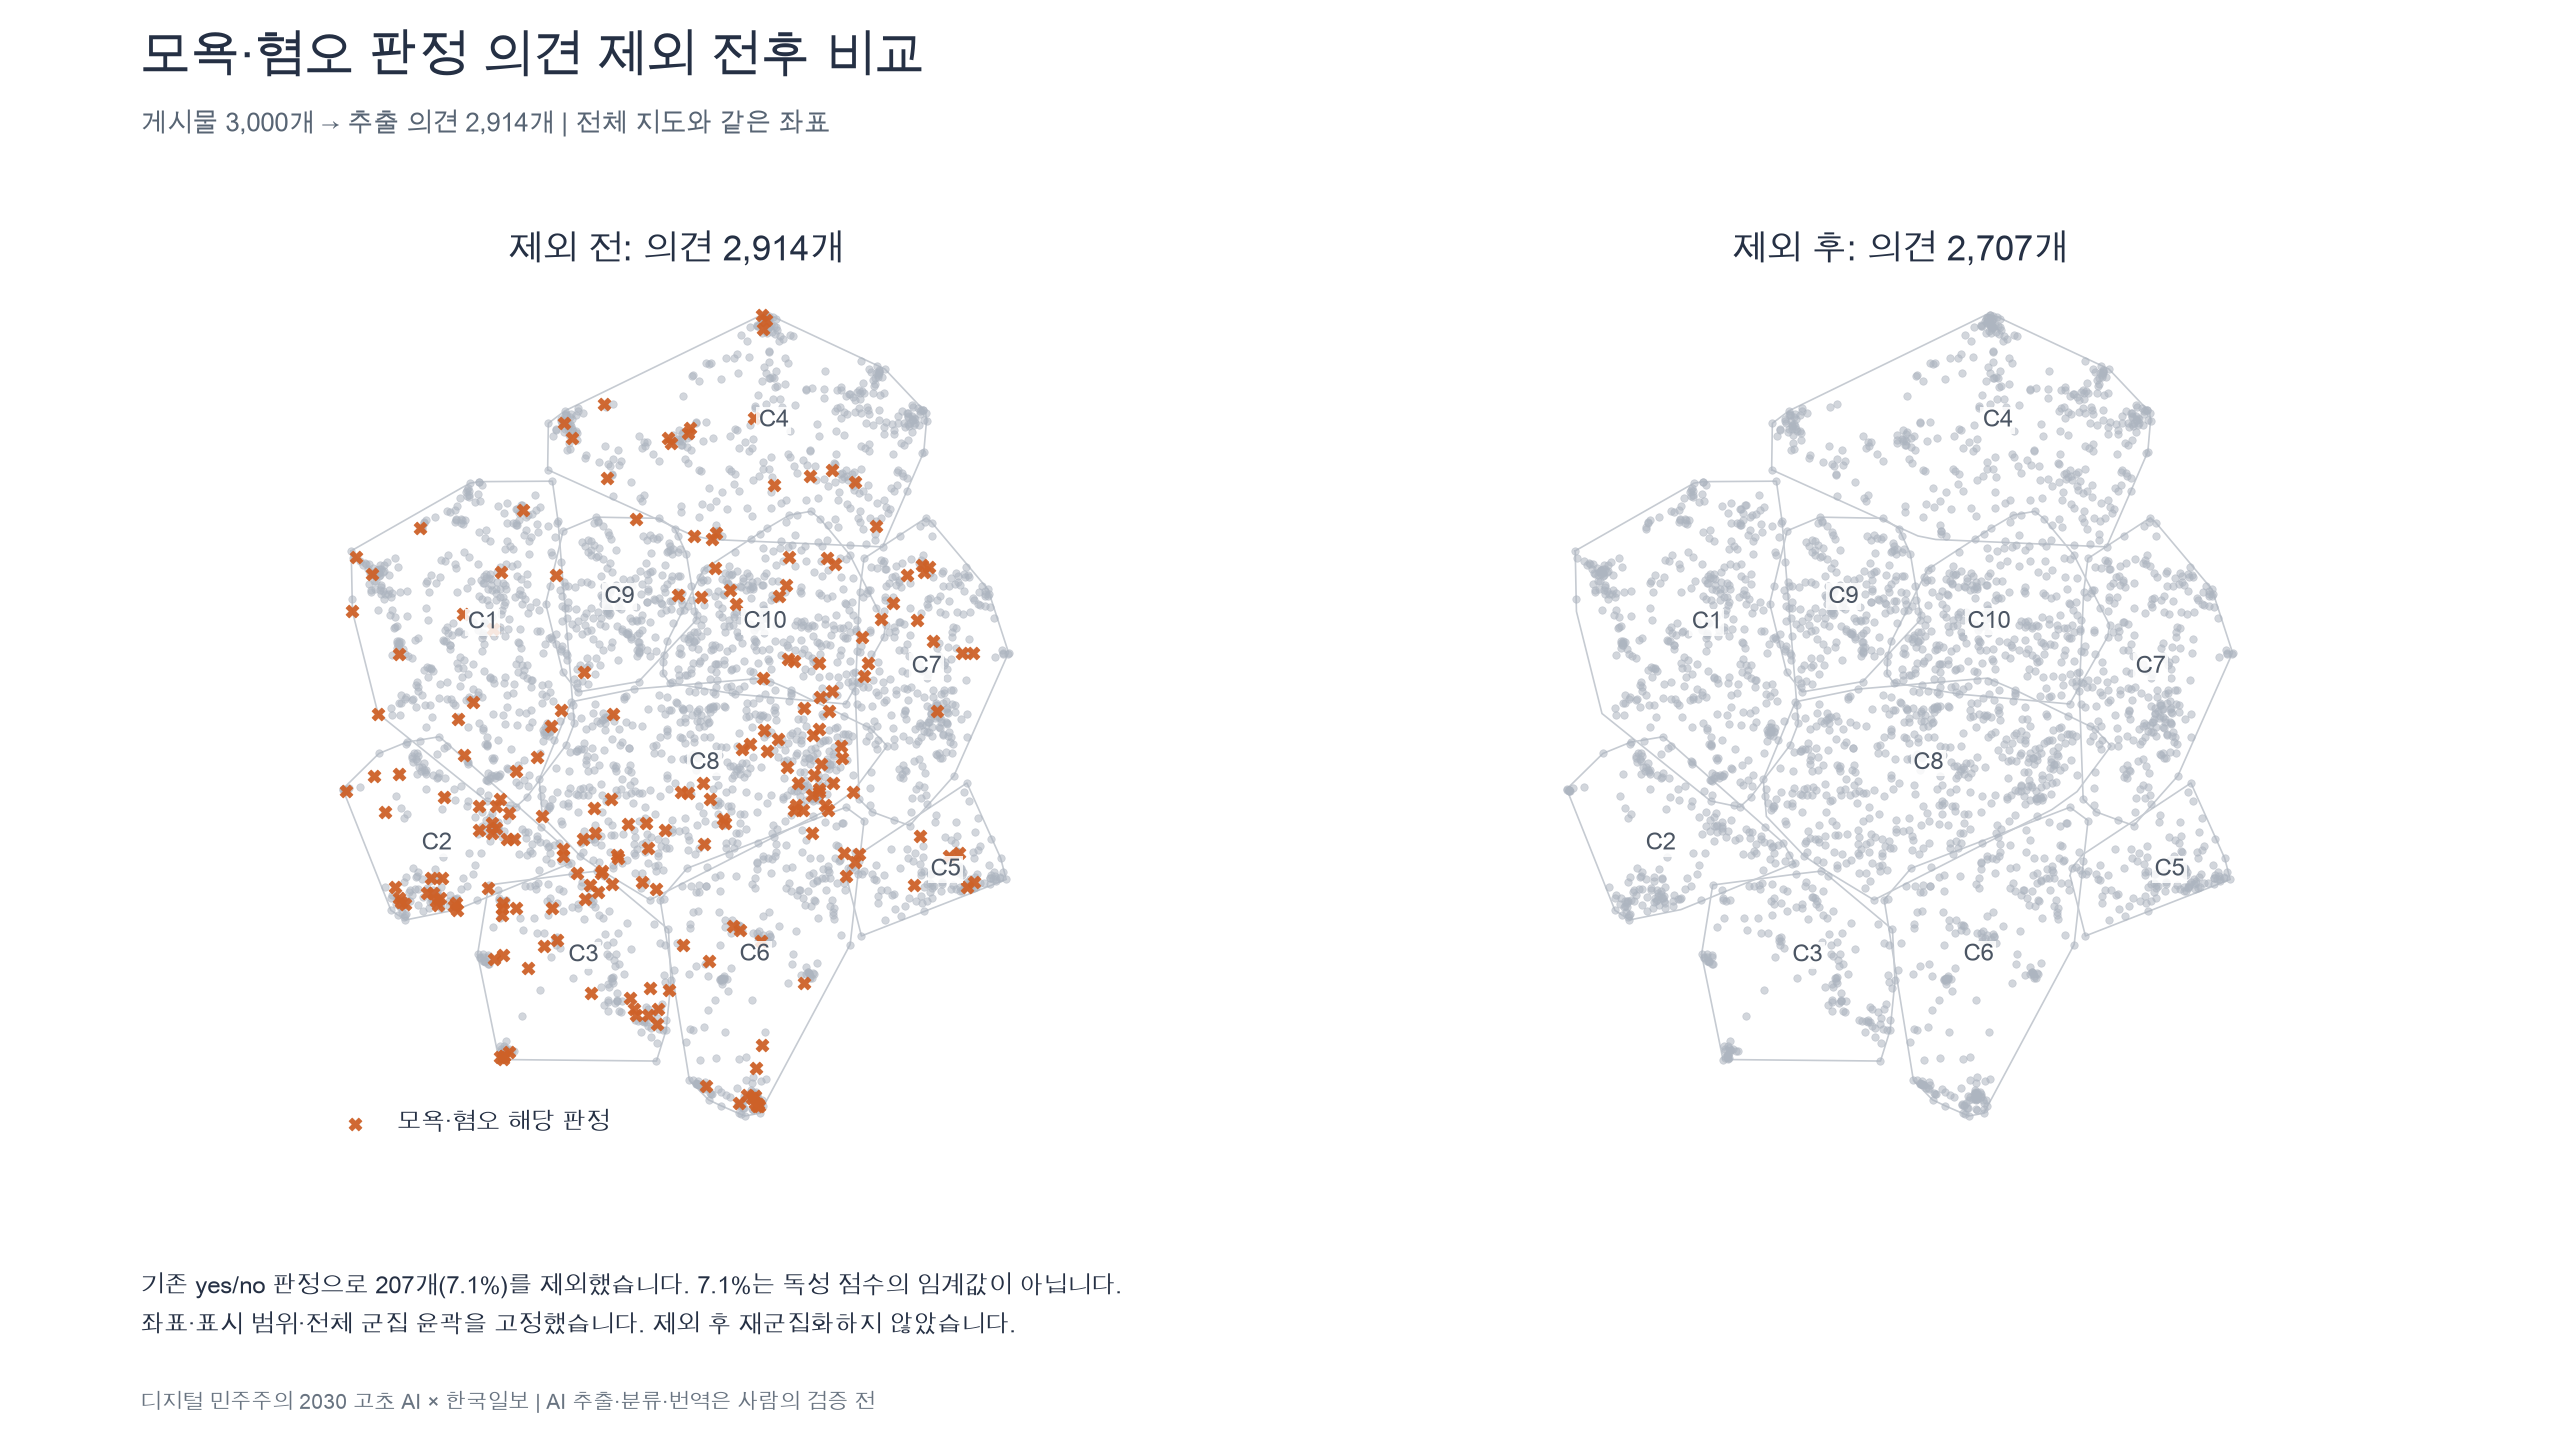
모욕·혐오로 판정된 의견은 7.1%
AI로 의견마다 모욕·혐오 표현에 해당하는지 판정한 결과, 2,914건 중 207건(7.1%)이었습니다. 이 의견들을 지우는 대신, 지도 위에서 어디에 있는지 보이도록 했습니다.
정책으로 이어질 의견은 적지만 있다
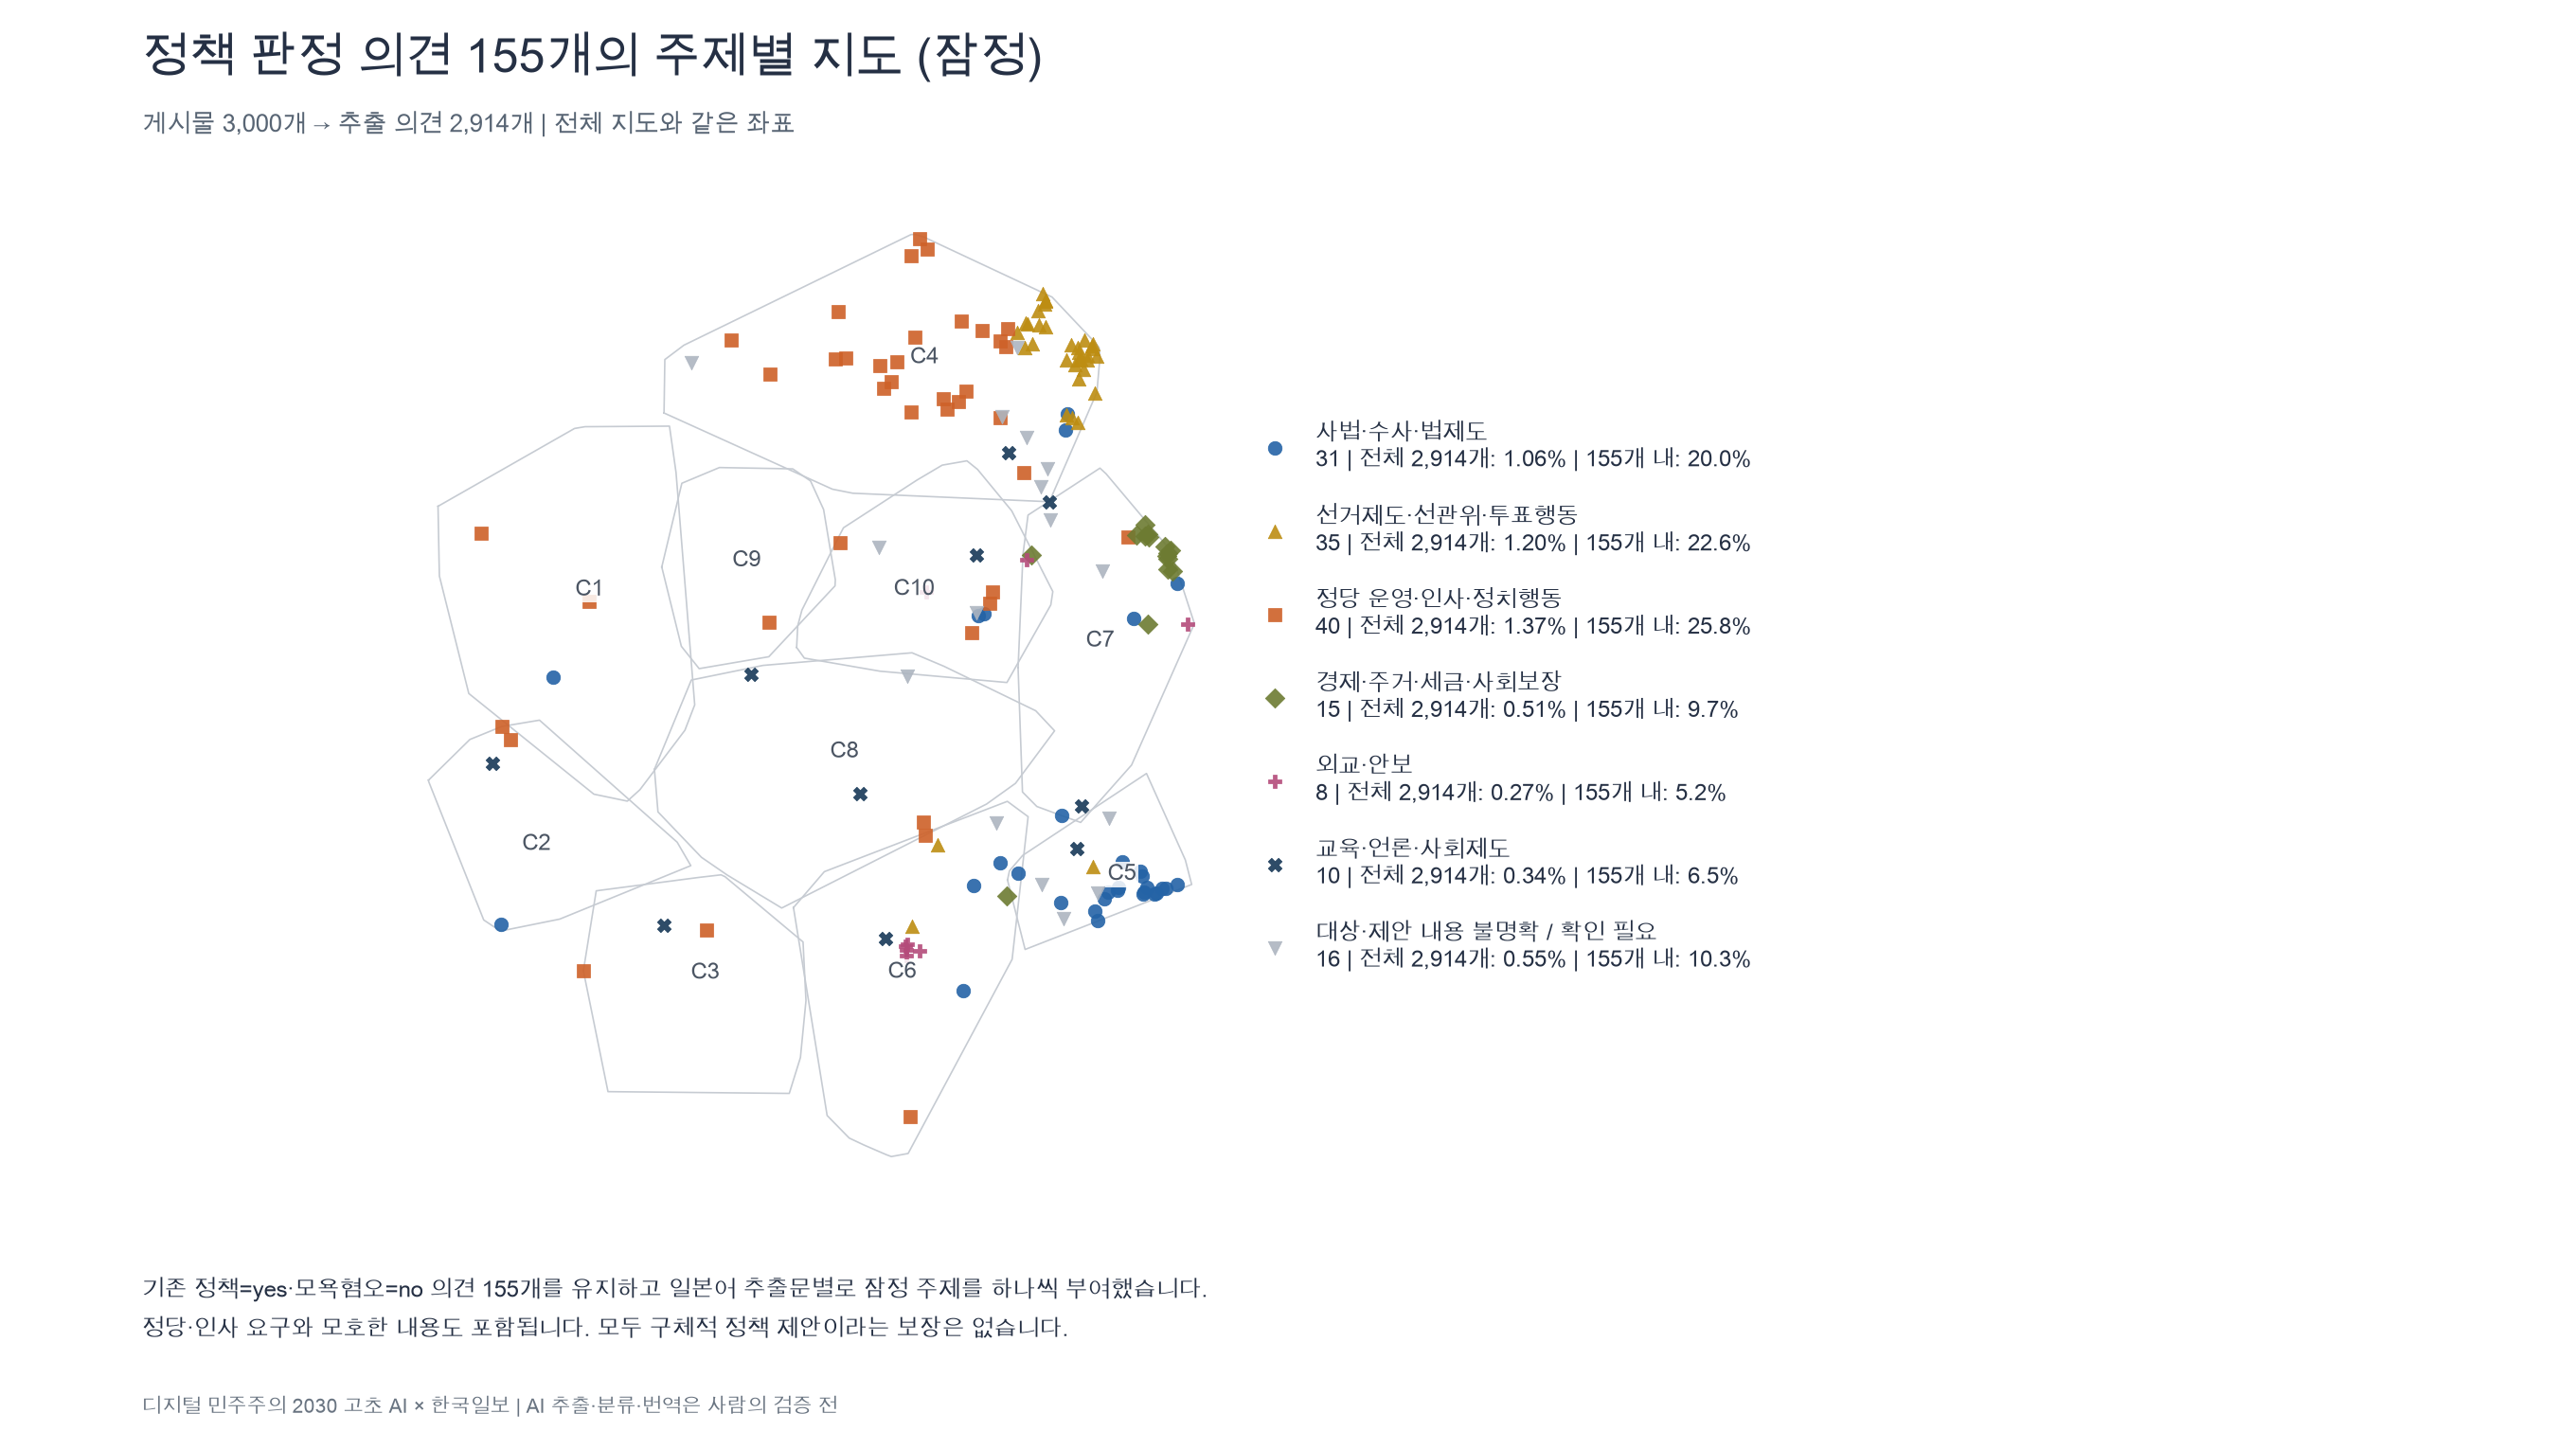
AI가 정책·제도에 대한 제안으로 판정하고 모욕·혐오로는 판정하지 않은 의견은 155건(5.3%)이었습니다. 사법·수사, 선거 제도, 정당 운영, 경제·주택·세금 등으로 나뉩니다. 주제는 일본어 추출 문장을 바탕으로 잠정적으로 붙인 것이며, 정당이나 인사에 대한 요구, 모호한 발언도 포함합니다.
읽을 때 주의할 점
- 3,000건은 채널마다 같은 수를 고른 것으로, 채팅 전체나 여론을 대표하는 표본이 아닙니다. 점의 수는 인원수나 지지율이 아닙니다.
- 그룹 이름·설명·추출 문장·판정은 AI가 만든 것으로 오류가 있을 수 있습니다. 예를 들어 그룹 이름이 내용과 맞지 않는 그룹도 있었습니다.
- 의견 추출은 일본어로 했으며, 영어·한국어는 그 기계 번역입니다. 한국어 화자의 확인은 거치지 않았습니다.
- 지도의 세로축·가로축에는 의미가 없습니다. 가까운 점일수록 내용이 비슷하다는 것 외에 배치에 의미는 없습니다.
- 데이터 제공처의 조건에 따라 원래 채팅 본문과 원문 링크는 싣지 않았습니다.
방법
고초 AI에서 gpt-4.1로 각 채팅에서 의견을 일본어 문장으로 추출하고, text-embedding-3-small로 벡터화했습니다. UMAP으로 2차원에 배치하고 k-means로 100개 그룹으로 나눈 뒤 Ward 방법으로 10개 그룹으로 묶었으며, 그룹 이름과 설명은 LLM으로 생성했습니다. 모욕·혐오와 정책 제안 판정은 일본어 추출 문장에 대한 AI의 yes/no 판정이며, 사람이 검증하지 않았습니다. 영어·한국어 번역은 로컬에서 실행한 Gemma 4 12B 계열 모델로 했습니다.